 マワルくん
・OpenAIのDecisions APIが何を返すのか知りたい
・JevやClefと何が違うのかを比べたい
・問い合わせの振り分けや写真の確認を自動化したい
OpenAIは2026年10月6日、判断のためのAPI「Decisions API」をベータ公開しました。9月のJev、10月1日のCloudflareのClefに続く判断の仕組みです。
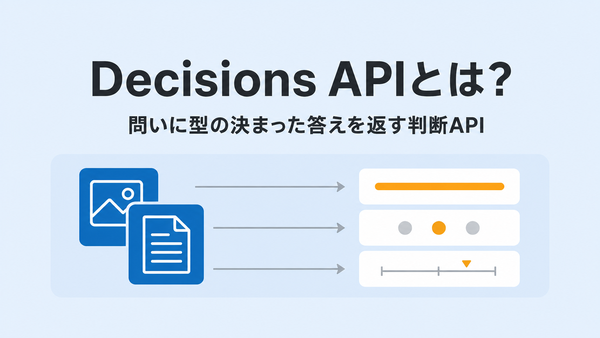
Decisions APIとは、テキストや画像を読み、あらかじめ書いた問いに確率・選択・段階の点で答えるOpenAIのAPIです。使いこなしの分かれ目は、モデルの速さより問いの書き方にあります。本記事では、3つの型、画像、問いの組み方、答えの読み方、料金、JevとClefとの違いを、2026年10月時点の公式情報で整理します。
この記事のゴール(読了目安 約8分)
Decisions APIの3つの型と料金の形を説明でき、自社の判断を試す前に、どんな問いを書けばよいかが分かるようになる。
Decisions APIとは
型の決まった答えを返す
Decisions APIは、文面や写真を材料に、こちらが書いた問いへ型の決まった答えを返します。返るのは条件が当てはまる確率、選択肢のどれか、段階の点のいずれかで、文章は返らないため結果をそのまま分岐に使えます。用途は分類・振り分け・優先度付けです。判断モデルそのものの考え方は、別記事で解説しています。
2026年10月6日にベータ公開
公開は2026年10月6日、全開発者向けのベータで、一般提供は数週間のうちの見込みです。使えるモデルはGPT-6 Lunaだけで、専用のエンドポイントで呼びます。SDKはPython 3.26.0、JavaScript 7.30.0以降などが必要です。
速さは、公式ガイドが「Responses APIより約10倍速い」、告知が「最大10倍」と書き、測った条件は示していません。10倍は目安で、自社の入力で測るまで設計の前提にしないのが安全です。公称の倍率を自社で測り直す方法は、別記事で解説しています。
質問は3つの型から選ぶ
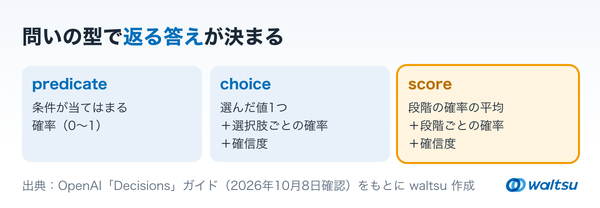
問いには型を1つ指定します。公式ガイドの説明を表にまとめました。
choiceとscoreはどちらも選択肢ごとの確率を返し、違いは選択肢に順序があるかどうかです。独自の形のデータや説明文が要るときは、Responses APIの構造化出力を使うよう公式は案内しています。
段階の点は確率の平均で返る
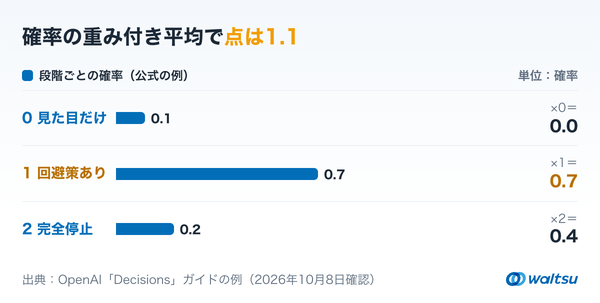
scoreの段階は0から数えます。公式の例では、不具合の深刻度を「見た目だけ」「回避策あり」「完全に止まる」の3段階で評価し、それぞれの確率が0.1、0.7、0.2でした。返る点は0×0.1+1×0.7+2×0.2で1.1です。
点は段階の間の値にもなり、1つの段階を選んだ結果ではありません。段階を1つに決めて処理を分けたいなら、choiceを使うよう公式も勧めています。
同じ1.1でも、確率が中央に集まるのか両端に割れるのかで意味は変わるため、段階ごとの確率も記録に残します。
画像は埋め込みで渡す
公式ガイドの最初の例は、製品の写真に目に見える傷があるかをpredicateで聞くものです。写真と「ひび・破れ・へこみがあるか。影と外箱の傷は無視する」という指示を送り、0.92という確率が返っています。
画像の渡し方には決まりがあります。
- 埋め込みだけ: Base64で符号化したデータURLとして本文に入れる
- URLとファイルIDは不可: ウェブ上の画像やアップロード済みのファイルは使えない
- 1回128枚まで: 1つのリクエストに含められる画像の上限
文字の指示と画像は同じメッセージに並べて送ります。社内の画像置き場のURLは渡せないので、画像を読み込んで変換する処理を手前に置くことになります。
問いは独立させて並べる
同じ入力への問いは、1回のリクエストにまとめられます。型は問いごとに変えてよく、写真なら傷の有無と製品の分類を一度に聞けます。
ただし、前の答えで次の問いが変わるなら、リクエストを分けます。傷があると分かってから修理の種類を聞く、という順番のある判断は1回にまとめません。
問いの書き方について、公式は次の4点を挙げています。
- 観察できる基準: 入力から確かめられることで問う
- 論点を分ける: 別の関心ごとは別の問いにする
- 選択肢の意味を分ける: 重なる選択肢を作らない
- 隣の段階を分ける: 段階どうしの基準をはっきり変える
選択肢で全ての入力を覆えないときは、「その他」を置いて人の確認に回すよう勧めています。
答えの読み方
predicateは確率を1つ返します。choiceとscoreは、選択肢ごとの確率の一覧と、それとは別の確信度を返します。公式の例では、部署の振り分けで請求担当の確率が0.95、確信度は0.93でした。確率の最大値と確信度は別の数字なので、どちらで線を引くかを先に決めます。
線は自社のラベル付きの例で、誤検知と見逃しの損を比べて決める、というのが公式の説明です。答えの代わりに拒否が返ることもあるため、その処理も最初から書いておきます。確率が実際に当たっているかを確かめる手順は、別記事で解説しています。
料金は入力だけにかかる
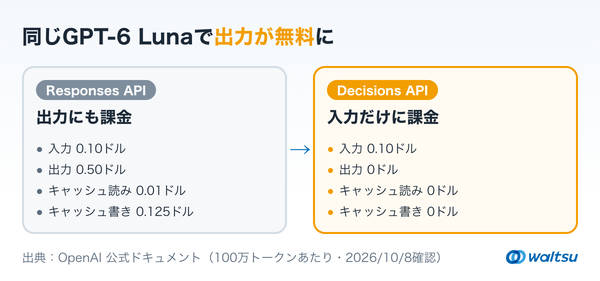
GPT-6 LunaでDecisions APIを使うと、入力100万トークンあたり0.10ドルです。キャッシュの読み書きと出力には料金がかかりません。地域処理の割増と、長い入力の倍率は適用されます。
同じGPT-6 LunaをResponses APIで呼ぶと、入力は同じ0.10ドルですが、出力に0.50ドル、キャッシュの読み込みに0.01ドル、書き込みに0.125ドルがかかります。答えが短い判断では、払うのはほぼ読ませた分だけです。逆に、長い資料や画像を毎回読ませる判断では、入力の量がそのまま費用になります。
音声の操作とつなぐ
公式ガイドは声での操作とのつなぎ方も載せています。会話はLive APIが受け持ち、アプリが会話の記録と画面の状態をDecisions APIに送って、次の操作を選ばせます。
例では、ブラウザへの「このページを再読み込みして」に対し、「戻る」「再読み込み」「何もしない」から再読み込みを選び、アプリが実行して結果を音声の側に返します。
込み入った依頼には「推論モデルに回す」という選択肢を置き、Responses APIで処理する形も示されています。速い判断で行き先だけを決め、考える仕事は別のモデルに渡す組み方です。
Jev・Clefとの違い
3つとも、問いを渡して確率付きの答えを受け取る仕組みです。2026年10月8日時点の公式ページで確かめた違いは次のとおりです。
単価だけならJevが最も安く、画像を多く扱えるのはDecisions APIです。すでにOpenAIを使っている会社なら、今の契約とデータ管理の設定のまま試せる点も違いになります。JevとClefを置き場所の観点で比べた記事は、別記事で紹介しています。
【プロの視点】見ないものを問いに書く
判断モデルの比較は、速さ・料金・正答率に向かいがちです。けれど答えの質を大きく変えるのは問いの書き方で、とくに何を見ないかを書いてあるかどうかです。
公式の傷の例は、「ひび・破れ・へこみ」と見る対象を挙げたうえで、「影と外箱の傷は無視する」と除外まで書いています。除外が無ければ、影を傷と取る写真や、外箱のへこみで確率が上がる写真が混ざります。
判断モデルは、問いがあいまいでも型どおりに確率を返します。文章で答えるLLMなら迷いが文面に出ることもありますが、ここでは0.6のような数字にしか表れません。あいまいな問いが生んだずれは、答えの形からは見えません。
「この汚れは数えない」「試供品は対象外」のように、現場が口では言えても紙に書いていない一言が、問いの精度を決めます。
明日やる最初の一歩は、自動化したい判断を1つ選び、担当者が「これは数えない」と言っている例外を3つ書き出すことです。
【waltsu視点】点検表を問いに写す
AIで記事制作を進めている支援先と話したとき、最初からエージェント化を目指すより、まず自分の業務をルール化するよう助言しました。判断モデルも同じで、言葉になった点検項目がなければ使えません。
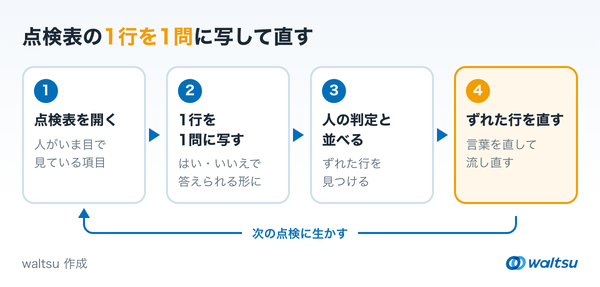
写し方は単純です。人がいま使っている点検表の1行を、predicateの問い1つに写します。「ラベルが決まった位置に貼られているか」なら、そのまま1問です。1行1問にしておくと、人の判定とずれた行が1行単位で分かります。
waltsuが軸にしているのは、時短ではなく試行回数です。ずれた行の言葉を直して流し直すたびに、点検表そのものが良くなります。判断モデルで自社のブログ記事を採点した結果は、別記事で紹介しています。
明日やる最初の一歩は、いま人が目で見ている点検表を開き、「はい・いいえ」で答えられない行に印を付けることです。
よくある質問
Decisions APIとは簡単にいうと?
OpenAIが2026年10月にベータ公開した判断用のAPIです。テキストや画像を読み、確率・選択・段階の点で答えます。
Responses APIとの使い分けは?
型の決まった答えで足りるならDecisions API、文章や独自の形のデータが要るならResponses APIです。
日本語でも使える?
2026年10月時点の公式ガイドには、対応言語の記載がありません。日本語の業務で使うなら、自社の実データで人の判断と突き合わせてから決めてください。
送ったデータの扱いは?
条件を満たす顧客は、データを保持しない設定(ZDR)や医療情報の規制(HIPAA)に沿った利用ができ、データの所在地は米国と欧州に対応しています。
いつから誰でも使える?
2026年10月6日から、全開発者向けのベータとして使えます。一般提供は数週間のうちの見込みなので、導入時に最新の仕様を確認してください。
この記事のポイント
・Decisions APIは、問いに確率・選択・段階の点で答えるOpenAIの判断API
・段階評価の点は確率の平均なので、1つに決めるなら選択の型を使う
・画像はBase64の埋め込みだけで、料金は入力だけにかかる
・答えの質は、見ないものまで書いた問いで決まる
まとめ
Decisions APIは、判断を型の決まった答えで受け取れるOpenAIのAPIです。画像を多く扱え、出力は無料ですが、まだベータでモデルはGPT-6 Lunaだけです。
JevやClefと同じく、速さや単価より先に決めるのは問いです。見る対象と見ない対象を書き、点検表の1行ずつを問いに写すところから始められます。判断の自動化でどこから問いにするか迷う場面が出てきたら、waltsuが業務の点検項目の洗い出しから検証の設計までご支援します。