 マワルくん
・CloudflareのClefが何者なのかを短く知りたい
・「Jevに勝った」という紹介を信じてよいか迷っている
・AIの判断に付く確率を、業務の線引きに使いたい
Cloudflareは2026年10月1日、自社で学習させた判断モデル「Clef」を公開しました。翌日には海外のSNSで「Jevを2週間で追い抜いた」という紹介も広まりました。
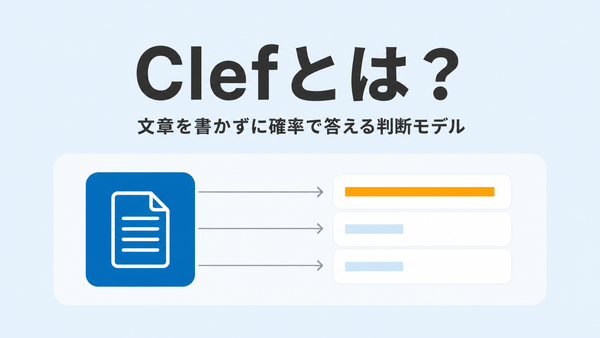
Clefとは、状況と選択肢つきの質問を受け取り、文章を書かずに各選択肢の確率を返すモデルです。Clefの新しさは速さよりも、確率の当たり具合まで学習で整えようとした点にあります。本記事では、自前で作った理由、仕組み、学習、ベンチマークの勝ち負け、調整と制約を、2026年10月時点の公式情報で整理します。
この記事のゴール(読了目安 約8分)
Clefの仕組みと公表値の強み・弱みを説明でき、自社で使う前に「その確率が本当に当たっているか」を確かめる手順が分かるようになる。
Clefとは
文章ではなく確率を返す
Clefは、問い合わせの文面などの状況と型の決まった質問を受け取り、許された答えそれぞれに確率を付けて返します。モデルは27BのClefと、9BのClef-flashの2つです。判断モデルの基本や返る3つの型は、別記事で解説しています。
2026年10月1日に公開
Workers AIのチームが初めて自ら学習させたモデルで、TypeSafe AIのJevと同じ形で呼べます。重みはApache 2.0でHugging Faceにも公開されました。名前は、楽譜の冒頭で音の高さを決める音部記号に由来します。呼び出し方や料金は、別記事で整理しています。
なぜ自前で作ったのか
社内に判断の仕事が多い
同社の社内には、判断モデルを組み込みたい業務がいくつもありました。
- サポート: 寄せられた問い合わせの振り分け
- 利用者の申告: 不正や有害な内容の通報の評価
- ボット対策: クローラーが良いボットか悪いボットかの判定
同社には15年を超えるネットワークのデータと、長年のラベル付きの判断があります。またJevへの関心を受けて、速く小さい分類モデルを、強化学習の製品を試す場に選んだと説明しています。
脅威情報の分類で試した
脅威情報チームは、ウェブサイトのドメインの分類でClefを試しました。ページを取得して描画する機能と組み合わせ、分類まで2.2秒です。同じ流れで同社最速の汎用LLMのgpt-oss-120bは4.7秒かかり、分類も2つだけでした。結果は「ファッション95%、フィッシング1%未満」のような確率の並びで返ると例示されています。
文章を書かずに答える仕組み
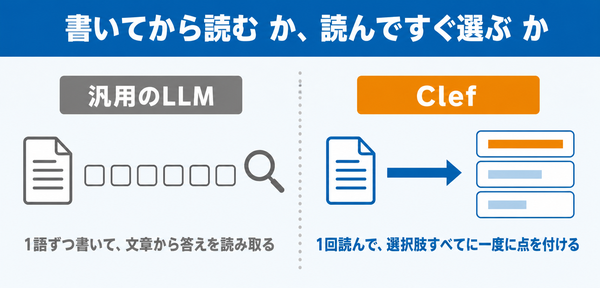
LLMは答えを1語ずつ書き、その文章から結果を読み取ります。Clefは途中の文章を一切書かずに、選択肢へ直接点を付けます。
- 1回で読む: 土台のQwenが入力を1回だけ読み込む
- 選択肢ごとに根拠を集める: 各選択肢が、入力の中から自分に関わる部分を拾う
- まとめて点を付ける: 質問同士と元の入力を突き合わせてから、すべての選択肢に一度に点を付ける
1語ずつ書く手順が無いぶん、汎用のLLMより大幅に速いと同社は説明しています。
確率を当たり率に合わせる学習
判断モデルの確率は、当たる割合と合っていて初めて役に立ちます。0.8と出た答えの約8割が正解という状態で、これを較正と呼びます。Clefの学習を、同社の説明から本記事で整理しました。
最後の段階は、同社が独自に作ったRLCD(較正された判断のための強化学習)です。エージェントが人に回すかを確率で決めるなら、その確率が当たり率と合っていることが前提になります。
ベンチマークで勝った所・負けた所
同社はJevを上回ったと発表しました。一方、Hugging Faceのモデルカードの全41評価で首位を数えると、Clef系が27、Jevが11、その他が3です。
問い合わせの分類や道具選びでは強く、深い推論が要る問題ではJevが大きく上回ります。小さいClef-flashは、対象外の見分けで大きく落ちます。
速さは中央値とp95で見る
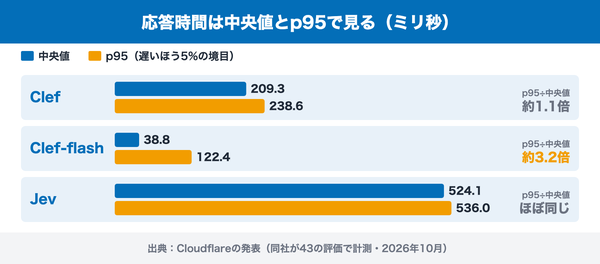
同社が43の評価を回して測った応答時間は、中央値でClefが209.3ミリ秒、Clef-flashが38.8ミリ秒、Jevが524.1ミリ秒でした。同社はClefを2.5倍、Clef-flashを13倍速いとしています。
もう1つの目安は、遅いほうの5%の境目のp95です。Clefは238.6ミリ秒で中央値の約1.1倍、Jevは536.0ミリ秒でほぼ同じ水準にそろっています。Clef-flashは122.4ミリ秒で、中央値の約3.2倍まで広がります。ふだんは最速でも、ときどき遅れる幅はClef-flashが最も大きいのです。処理の途中に置くなら、待てる上限はp95で決めます。自社から測るときの分け方は別記事で解説しています。
公表値を読むときの注意
数字は次の4点を踏まえて読みます。
- 測ったのは発表元: 評価も速さも、Cloudflare自身の計測
- 選ばれた10評価: 発表の表は判断に重要な10評価を選んだもので、そのうち7つでClef系が首位
- 業務の評価は3勝1敗: TypeSafeの業務評価では、エージェントの記録の監視だけJevが上
- SNSの要約: 「Jevより4倍速く精度は2倍」という紹介は、公式の2.5倍と合わない
精度が2倍近く開いたのは、家電の操作を模した評価(Clef-flash 97.7、Jev 52.3)など一部です。見出しの倍率ではなく、自社の業務に近い評価の行を探して読むのが確実です。
強化学習で自社向けに調整する
Clefを業務に合わせて調整するサービスも始まりました。最初は同社のFDE(顧客の現場に入る技術者)が伴走し、利用者が自分で調整できる仕組みは後から用意するとしています。FDEの役割は別記事で解説しています。使う部品は次の5つです。
- AI Gateway: AIへの通信を通し、記録から学習用のデータを作る
- Workers AI: 元のClefで試しの判断を出す
- Containers: エージェントの動きを採点し、再生する隔離環境
- Trainer: 調整したClefの重みを更新する新しい部品
- 持ち込みモデルの実行: 調整したモデルをWorkers AIに戻して動かす
同社は、調整すると特定の業務の精度と引き換えに、汎用の性能を一部手放すことがあるとも書いています。
使う前に知っておく制約
- データの扱い: リクエストと応答を読まず、保存せず、学習にも使わないと約束。調整サービスは例外
- 自前で動かす重さ: モデルカードの動作確認は、データセンター向けのGPU(H200)1枚
- 動画: モデルカードは動画も読めると書くが、Workers AIで添付できるのは画像だけ
- 土台はQwen: ライセンスも土台に合わせたApache 2.0
日本語での成績は、2026年10月時点で公表されていません。
【プロの視点】確率は当たり率で検算する
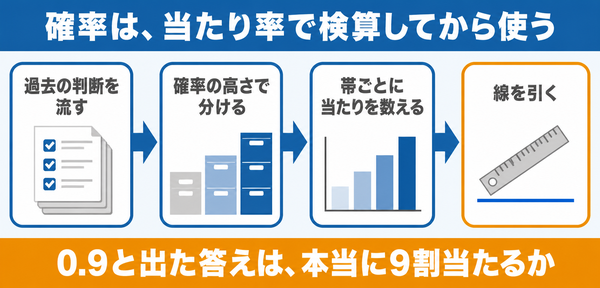
判断モデルの議論は、ベンチマークの順位に向かいがちです。けれど、エージェントに組み込むときに問われるのは0.9と出た答えが本当に9割当たるかどうかです。人に回す線は確率で引くので、確率がずれていれば、線は思った場所に引かれません。
Clefは確率の当たり具合まで整えたと説明していますが、それは同社の合成データでの話です。自社の文面や日本語で同じ当たり具合が出る保証はなく、調整すれば確率の分布も動きます。
確かめ方は単純です。人が正解を付けた過去の判断を流し、出た確率を「0.9以上」「0.7〜0.9」「それ未満」に分け、帯ごとに当たった割合を数えます。0.9以上の帯で当たりが7割なら、その確率は高く出すぎています。線を引くのは、帯ごとの当たり率を見てからです。外れ方の傾向から確認の置き場所を決める考え方は、別記事で解説しています。
明日やる最初の一歩は、いま使っているAIの判断の記録から確率が0.9以上だった件を20件抜き出し、人が見て何件当たっていたかを数えることです。
【waltsu視点】人が直した判断を残す
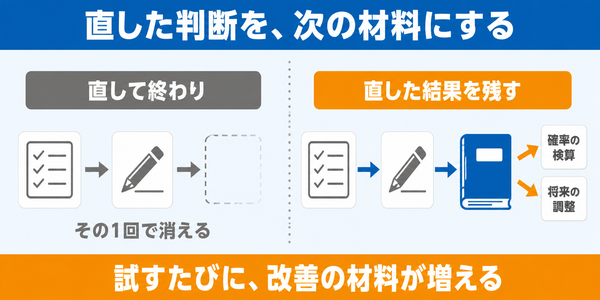
Cloudflareが調整を始められたのは、長年のラベル付きの判断があったからです。同じ材料は小さな会社にもあります。AIの判断を人が承認した、あるいは上書きした記録です。
waltsuが軸にしているのは、時短ではなく試行回数です。人に回ってきた判断を直して終わりにすると、その試行は1回きりで終わります。直した結果を残せば、確率の検算にも、将来の調整にも使える材料に変わります。同社の調整サービスも、日々の通信を記録して学習データにする設計です。
判断モデルを入れる価値は自動化だけでなく、試すたびに改善の材料が増えることにあります。判断モデルで自社の記事を採点した結果は、別記事で紹介しています。
明日やる最初の一歩は、AIから人に回している判断の一覧に「人の最終判断」の列を1つ足すことです。
よくある質問
Clefとは簡単にいうと?
Cloudflareが公開した判断モデルです。文章を書かず、決めた選択肢それぞれに確率を付けて返します。
Jevとの違いは?
同じ形で呼べ、Clefは画像も読めます。同社の計測では速く分類に強い一方、深い推論ではJevが上です。
Clefは無料で使える?
重みはApache 2.0で公開されており、自前のGPUで動かせます。Workers AIで呼ぶ場合は従量課金ですが、2026年10月時点で1日あたりの無料枠があります。
送ったデータは学習に使われる?
同社は、リクエストと応答を読まず、保存せず、学習にも使わないとしています。調整サービスを使う場合は例外です。
自社向けに調整できる?
できます。まず同社の技術者の伴走で提供され、自分で調整できる仕組みは後から出る予定です。
この記事の要点
・Clefは文章を書かず、選択肢に確率を付けて返すCloudflareの判断モデル
・確率の当たり具合をブライアスコアとRLCDで整えたのが学習の要
・分類や道具選びではJevを上回り、深い推論ではJevが上
・確率は自社の過去の判断で、帯ごとの当たり率を検算してから使う
まとめ
Clefは、Cloudflareが自社の判断業務をもとに作った判断モデルです。文章を書かずに選択肢へ点を付けるので速く、確率の当たり具合まで学習で整えています。一方で公表値は同社の計測で、深い推論が要る評価ではJevが上回ります。
エージェントに判断を任せるなら、順位より先に、自社のデータで確率を検算することです。判断モデルの選定や、人に回す線の引き方に迷う場面が出てきたら、waltsuが判断の記録の設計から確率の検算までご支援します。