 マワルくん
・自分のコードからJevを呼んでみたい
・レイテンシと費用が自社の使い方でいくらになるか知りたい
・LLMのどこをJevに置き換えるか決めたい
「193.6倍速い」「444.6倍安い」といった倍率は次々と流れてきますが、自分のコードに置いたときに何がどう返るのかは、読んでもはっきりしません。料金も100万トークンあたりの単位で示されるため、自社の件数でいくらになるかは別に計算しないと出てきません。
Jevは、TypeSafe AIが公開している判断のためのモデルで、文章ではなく型の決まった値を返します。導入の材料になるのは公称の倍率ではなく、自分の件数を入れて出した1判断あたりの費用です。本記事では、最初の1リクエストを通す手順、リクエストとレスポンスの形、2か所にある上限、レイテンシの測り方、費用の計算式、LLMとの役割分担、使いどころの見極め方までを順に扱います。
この記事を監修した人
AIエンジニア
小洞 映ハユル コボラ
この記事のゴール(読了目安 約10分)
Jevのリクエストとレスポンスの形を説明でき、自社の件数でレイテンシと費用を見積もったうえで、どの処理に使うかを自分で決められるようになる。
最初の1リクエストを通す
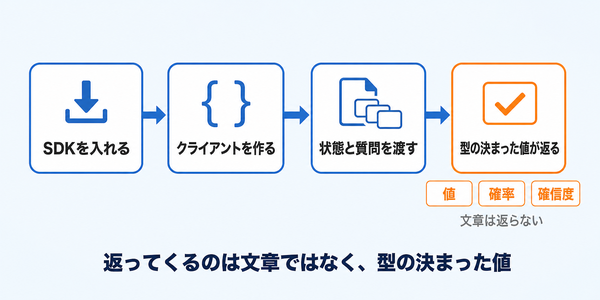
入れるのはSDKひとつ
公式のクイックスタートに載っているのは、PythonのSDKから呼ぶ例と、cURLで直接送る例の2つです。導入はこの1行だけで、ほかに準備するものはありません。
pip install typesafe-sdkサーバーの用意もモデルの取得も要りません。素のAPIで足りる処理と、枠組みが要る処理の切り分けは別記事で解説しています。
鍵は環境変数に置く
クライアントは TypeSafeClient() のように引数なしで作る形が公式の例です。APIキーは環境変数から読ませ、コードには書きません。cURLで送るなら宛先は POST https://api.typesafe.ai/v1/systemone、ヘッダは Authorization: Bearer $TYPESAFE_API_KEY、本文に state とモデル名(jev-latest)、questions を入れます。
送る中身はどちらでも同じなので、先に環境変数の置き場所を決めてから書き始めます。
サンプルを1本まるごと読む
何を聞いているコードか
公式のサンプルは、サポートに届いた1通の問い合わせを題材にしています。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

ticket = "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)
判断の材料になる文面を state に渡し、questions に3問を並べています。どの部署が扱うか、どれくらい苛立っているか、急ぎかどうかです。3問とも型が違うのに、送るリクエストは1回だけです。返ってくる3つの型と、確信度をどう使うかは別記事で解説しています。
返った3つの値を見る
print(response.answers["department"].choice)  # "technical"
print(response.answers["frustration"].score)  # 1.0
print(response.answers["is_urgent"].noul) # 1.0取り出しているのは決まった名前の値だけで、文章を読み解く処理はありません。公式の入門ページは All three question types can be mixed in a single API call. Every question is evaluated in parallel and in isolation against the same state in one go と書いています。3種類を1回に混ぜられ、互いに影響せず並列に評価されるという意味です。
リクエストの組み立て方
状態には何を入れるか
入力について公式のモデル仕様は Text only. String, JSON object, or array of text values. No image, audio, or video input. と記載しています。文字列のほか、JSONのオブジェクトやテキストの配列も渡せます。
裏を返すと、画像・音声・動画はそのまま渡せません。紙の申込書や電話の録音は、文字に起こす処理をJevの前に置くことになります。
質問は型を選んで書く
質問には instructions(何を判断させるか)と criteria(選択肢や尺度)を書きます。難しいのは後者で、選択肢を書き切れるかが、そのまま質問を書けるかになります。次の3点を確かめてから書きます。
- 選択肢が重なっていないか: 2つに当てはまる事例で答えが揺れます
- どれにも当てはまらない受け皿があるか: 無いとどれかへ無理に寄ります
- 1問に2つの論点を混ぜていないか: 「緊急で重要か」は2問に割ります
受け取り側にパースが要らない
文字列を切り出さない
文章で答えが返る前提だと、受け取り側には決まった処理が並びます。必要な部分を切り出し、形式どおりかを確かめ、外れていたら投げ直す。型の決まった値が返るなら、この3つは不要になります。
減るのはモデルの料金ではなく、受け取り側のコードと、そこで起きていた例外処理です。
確率と確信度も一緒に返る
返ってくるのは値だけではなく、その値になった確からしさも一緒に付いてきます。つまり自動で流す件と人に回す件を、受け取った値だけで振り分けられます。
ただし、しきい値をどこに引くかの設計は、この記事では扱いません。
上限は2か所にある
1回に入る量の上限
1リクエストの上限は 64k tokens per request; 32k tokens for state plus the longest question と記載されています。全体の上限と、状態と最長の質問を合わせた上限が別に置かれています。
長い状態を渡すほど、1回に足せる質問の余地が減ります。資料を丸ごと渡す設計だと、質問を増やしたいときに入らなくなります。
処理量の上限は動く
アカウント側の上限は 250,000 tokens per second / 1,200 requests per minute です。毎分1,200は毎秒20リクエストにあたります。ただし公式は Rate limits are adjusting dynamically と明記しています。
上限は変わる前提で読み、本番の処理量をこの数字の前提で組まないことです。
レイテンシは2つに分けて測る
モデルが処理した時間
同社の公式ブログが挙げる公称値は End-to-end response time is 70ms-500ms for TypeSafe、比較対象は 3 to 329 seconds for frontier models です。Jev側の値は同社の測定で、第三者が追試した結果ではありません。比較対象は同社が引いた外部の計測サイトの値です。
自社から見た往復の時間
自社のアプリから見える時間には、ネットワークの往復と自社側の前後処理が乗ります。公称の70〜500ミリ秒を、そのまま画面の応答時間として見積もらないことです。測るのは次の2つです。
- モデルが処理した時間: 応答に含まれる処理時間そのもの
- アプリから呼んで返るまでの時間: 自社のコードで計った往復
この差から、自社の環境で時間がかかっている場所が分かります。なお速さとは別に、返ってきた判断の正しさをどう測るかは別記事で解説しています。
公称の倍率を代表値にしない
同社が高い側と書いている
193.6x faster, 444.6x cheaper という数字は、同社自身が高い側の見積もりだと説明しているものです。速度の公称 40x-200x faster for the same levels of frontier intelligence も同社の測定で、幅の上端を前提にすると自社の見積もりがまるごとずれます。
ハルシネーションが起きないという説明も、0%という数字は同社の評価として示されたもので、外部機関の検証結果ではありません。
第三者の標準評価は無い
第三者機関による標準的なベンチマークは公表されていません。一方で、個人や企業の技術ブログによる小規模な実測は公開され始めています。
参考にはなりますが、読み方に条件が付きます。数値を引くなら、誰が・何件で・どの言語で測ったかまで見ることです。
1判断あたりの費用を出す
式は入力トークン×単価
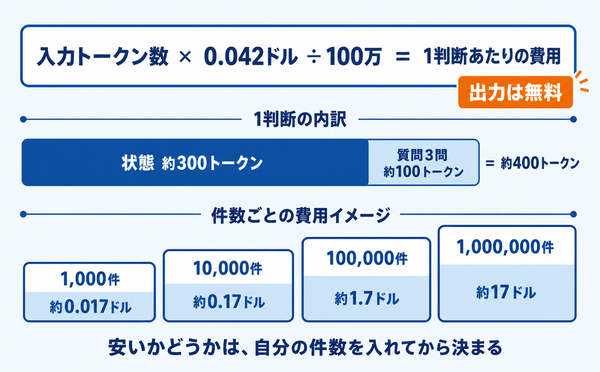
料金は入力が $0.042 / MTok($42 per billion tokens)、出力が FREE (too cheap to meter) と記載されています。計算に入るのは入力だけです。
1判断あたりの費用=入力トークン数×0.042ドル÷1,000,000
出力が無料なので、費用は書かせる量ではなく読ませる量で決まります。
400トークンで検算する
問い合わせ1通の本文を約300トークン、質問3問を合わせて約100トークンとすると、1判断は約400トークンです。1万件なら400万トークン、4 MTokなので、4×0.042ドルで約0.17ドルになります。
桁の確かめには公式のデモが使えます。毎秒10回の判断で ~$7/hour とあり、1時間で約3万6千回なら1回あたり約0.0002ドル、逆算すると1回およそ4,600トークンです。
件数を入れて月額にする
いずれも1判断を約400トークンとして計算した場合です。1件あたりのトークン数は、状態の長さと質問の数で変わります。大量に処理する場合の従量課金と固定投資の比べ方は別記事で解説しています。
判断はJev、文章はLLM
Jevの前後にLLMを置く
全部を置き換える話ではありません。既存の処理のうち、文章を書かせている場所ではなく、判断させている1か所だけを切り出す形になります。
典型は入口での振り分けで、Jevが分類と緊急度を返し、返信文が必要なものだけLLMへ回す流れです。生成AIとエージェントで費用が膨らむ場所が違う点は別記事で解説しています。
呼ぶ順番で費用が変わる
先にJevで絞ってからLLMを呼ぶか、先にLLMに読ませるかで、LLM側に流れる件数が変わります。費用を左右するのはJevの料金ではなく、LLMに回さずに済んだ件数のほうです。順番を入れ替えるだけで月の請求が変わります。
制約は実装側で手当てする
公式が挙げている制約は、モデルが新しくなれば消えるものではありません。どれもJevの外に何を置くかで手当てするものです。主なものは4つあります。
言語は English is the primary training language and where accuracy is currently best と明記され、日本語を含むCJKも扱えるが同等ではない、という書かれ方です。自社のデータで測る以外に、日本語での精度を知る方法はありません。
コスパが出る条件は3つ
件数がまとまっているか
1件あたりが安いことは、件数が少なければ意味を持ちません。月に数十件なら費用は誤差の範囲です。安さが利点になるのは、同じ判断が繰り返し大量に発生する処理だけです。
答えを先に書き切れるか
選択肢を先に書き切れない判断は、そもそも質問の形になりません。逆に、人が手順書を見ながら分類している処理なら、選択肢はすでに文章になっています。やってみないと選択肢が分からない仕事は、まだ切り出す段階にありません。
外れた件を誰が見るか
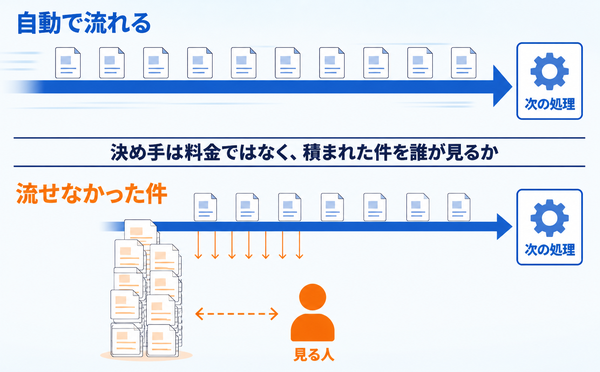
自動で流せなかった件は、人の列に積まれます。そこを見る人が決まっていないなら、導入しても処理は終わりません。3つのうち1つでも欠ければ、速さと安さは成果に変わりません。
【プロの視点】安さは決め手にならない
Jevの紹介は、たいてい倍率と単価で終わります。444.6倍安い、出力は無料、と。ところが先ほどの表を自分の件数で読むと、多くの会社で費用は判断材料にならない桁になります。月に1万件の判断でも0.2ドルに届きません。判断材料にならないものをいくら比べても、導入は決まりません。
見るべきは料金ではなく、自動で流せなかった件を誰がさばくかという時間です。ここを外すと、速く安い仕組みを入れたのに処理が終わりません。
AIで記事を作る工程を自社で組んだときは、1日3〜4記事を作れる状態になっても、公開済みが23記事で止まっていた時点がありました。時間がかかっていたのは生成ではなく、入稿と画像の確認、リンクの確認、そして公開してよいかの判断のほうです。速くて安い工程を作ると、制約はその先へ移ります。
同じことが判断の自動化でも起きます。判断そのものが毎秒20件返るようになっても、確信度の低い件を見る人の処理量は変わりません。速くした工程の下流に、人が見る新しい列ができるだけです。
明日やる最初の一歩は、自動化したい判断が1日に何件あり、そのうち人が迷うのは何件かを数えることです。迷う件数が、置くべき人の時間を決めます。
【waltsu視点】まず自社の件数を数える
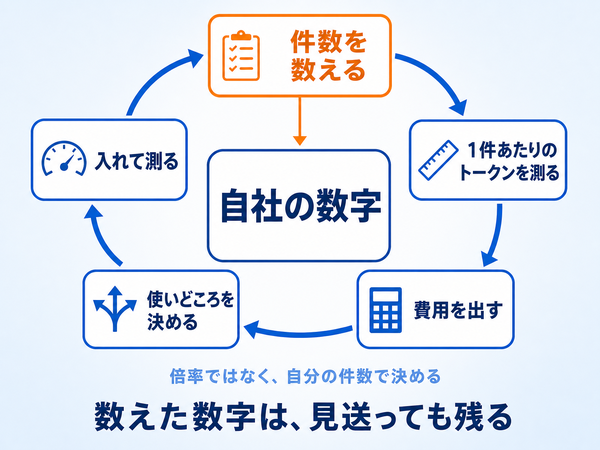
見積もりは導入の可否を決める作業に見えますが、実際は自社の業務を数え直す作業です。数えた数字は導入を見送っても残り、次に別の道具を検討するときに使えます。
問い合わせフォームの運用状況を確認した企業では、月の送信が40〜50件ありました。そのうち営業メールなどを除くと、問い合わせと呼べるものは20〜30件程度です。この20〜30という数字を先ほどの式に入れると、1件を400トークンとして計算しても、月の費用は0.001ドルに届きません。桁を出した時点で、料金は比べる対象から外れます。
数字が出ると、議論は「安いらしい」から「うちは月何件で、1件はおよそ何トークン」に変わります。比べる対象が製品ではなく、自社の処理量になります。
費用は月額ではなく1件あたりで持っておきます。1件の値段が分かっていれば、件数が10倍になったときの請求額は掛け算で出ます。
waltsuが編集の軸にしているのは、試行回数を増やすことです。見積もりは、試す回数を増やすための準備にあたります。数字の単位を持っていれば、入れた後に効果を測れて、次の一手が速くなります。明日やる最初の一歩は、自動化したい判断を1つ選び、先月の件数と、1件あたりの入力のだいたいの文字数を書き出すことです。この2つがあれば、先ほどの式で計算できます。
よくある質問
JevはPythonから使える?
公式のクイックスタートには、PythonのSDKを使う例とcURLで送る例が載っています。導入は pip install typesafe-sdk の1行で、クライアントを作ってから判断の材料と質問を渡す形です。
1回に質問は何問入りますか?
問数ではなくトークンで決まります。1リクエストで64,000トークン、そのうち状態と最長の質問の合計で32,000トークンが上限です。状態が長いほど足せる質問は減るので、渡す材料を絞るほど質問を増やせます。
月の費用はどう見積もる?
入力トークン数×0.042ドル÷100万で1判断あたりを出し、月の件数を掛けます。出力は無料なので計算に入りません。先に1件あたりのトークン数を決める順番にすると、件数が変わっても計算し直さずに済みます。
公称の速さは自社でも出る?
公称の70〜500ミリ秒は同社の測定値です。自社のアプリから見える時間にはネットワークの往復と前後の処理が乗るため、モデルの処理時間と往復の時間を分けて測ります。
レート上限を超えたら?
毎秒250,000トークン、毎分1,200リクエストが上限として示されています。公式は上限を動的に調整すると明記しているため、本番の処理量をこの数字の前提で設計しないことです。件数が多い処理は、質問をまとめて回数を減らす方向で組みます。
この記事の要点
・返ってくるのは型の決まった値。受け取り側に切り出しと形式の確認が要らない
・上限は2か所。1リクエストの64,000トークンと、アカウントの毎秒・毎分
・費用は入力トークン数×0.042ドル÷100万。出力は無料
・倍率ではなく、自分の件数を入れて出した数字で決める
まとめ
Jevを組み込む作業そのものは短く済みます。SDKを1つ入れ、判断の材料と質問を渡し、型の決まった値を受け取るだけです。手間がかかるとすれば、選択肢を書き切れない質問と、1リクエストに入らない長い状態の2か所です。
決めるべきことは、そこから先にあります。自社の件数を数え、1件あたりのトークン数を出し、月額を計算する。多くの場合、その数字は判断材料にならない桁に収まります。残るのは、自動で流せなかった件を誰がいつ見るかという問いで、ここに答えがある処理だけが、切り出して効果の出る処理です。
どの判断を切り出し、どこに人を残すかの線引きに迷う場面が出てきたら、waltsuが業務の切り分けから見積もりの設計までご支援します。