 マワルくん
・Jevという名前だけ聞いて中身が分からない
・LLMとの違いと使いどころを知りたい
・自社の業務に関係があるのか判断したい
2026年9月、Jevという新しいAIモデルの話題が開発者の間で広がりました。ところが流れてくるのは「何倍速い」「出力は無料」という数字ばかりで、何を返すモデルなのかは分からないまま、という方が多いはずです。
JevはTypeSafe AIが2026年9月15日に早期提供を始めたモデルで、文章を生成せず、あらかじめ決めておいた選択肢・尺度・真偽の中から型付きの値と確信度を返します。Jevで見るべきは速さではなく、返るのが値と確率だけで理由が返らないことです。本記事では、LLMとの違い、3つの質問の型、確信度で人に回す線の引き方、日本語で使うときの注意、いま試せるのかまでを解説します。
この記事のゴール(読了目安 約10分)
Jevが何を返すモデルかを説明でき、自社のどの判断なら渡せるか、日本語で使う前に何を確かめるかを決められるようになる。
Jevとは
文章ではなく判断を返す
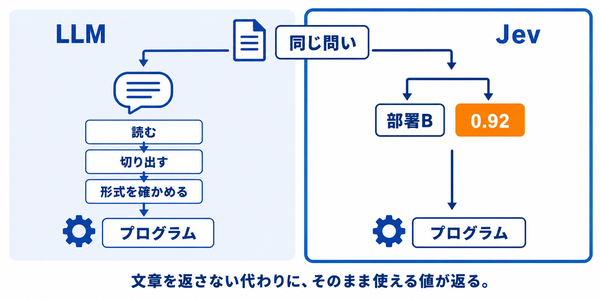
Jevは、取りうる答えをこちらが先に書いておき、その中から1つを選んで返すAIモデルです。返るのは選ばれた値と、それに付いた確率と確信度だけで、文章は1文字も返りません。Jevが返すのは人に読ませる文章ではなく、ソフトウェアがそのまま使える判断です。
System Oneという呼び方
TypeSafe AIは、この種のモデルをSystem Oneモデルと呼んでいます。言葉を尽くして考えるのではなく、即座に決めるほうを担うという位置づけです。2026年9月19日時点で、Jevは早期アクセスの段階です。
LLMとの違い
出力の形が違う
LLMに同じ問いを投げると、答えは文章で返ります。プログラムで使うには、そこから必要な部分を切り出し、形式が崩れていないかを確かめる工程が要ります。Jevならこの工程ごと不要です。返った値をそのまま次の処理に渡せる点が、LLMとの一番の違いです。
得意な仕事が違う
そのかわりJevは文章を生成しません。JevはLLMの置き換えではなく、LLMの横に置く判断の層です。自律的に動くAIエージェントの中では、判断を担う部品にあたります。
返ってくる3つの型
質問の型は3つで、TypeSafe AI公式ドキュメント「はじめに」ではChoice・Score・Noulと表記されています。
選択肢から選ぶChoice
一覧の中から1つを選ばせる型です。問い合わせの文面を渡し、どの部署に回すかを選ばせる使い方が分かりやすい例です。選ばれた選択肢と、選択肢ごとの確率、そして確信度の3つが返ります。
尺度で点をつけるScore
決めておいた尺度で採点させる型です。申込内容を渡して緊急度を5段階で付ける、といった使い方になります。点数の意味は人が決めた尺度の側にあり、モデルが決めるわけではありません。
真偽の確率を返すNoul
「この記述は真か」を0から1の値で返す型です。この文面は社外に出してよいか、といった判定に向きます。綴りはNoulで、NullでもBoolでもありません。
1回の呼び出しで並列に答える
状態と質問を分けて渡す
Jevに渡すのは、判断のもとになる状態と、型を決めた質問の2つです。状態は文字列でも構造化したデータでも構いません。1回の呼び出しに3つの型を混ぜられます。
質問を足しても遅くならない
各質問は同じ状態に対して並列に、かつ互いに独立して評価されると公式は説明しています。質問を足しても応答時間はほとんど変わらないため、1つの大きな判断を細かい問いに割って投げられます。
ハルシネーションが起きない理由
形式は必ず守られる
同社の説明では、出力の候補と構造を先に定めることで型の誤りが起きない仕組みです。決めた選択肢の外の値は返らず、数値が文字列で返ることもありません。
選択の正しさは別
ただし保証されるのは形式であって、選ばれたものが正しいという意味ではありません。3つの部署から必ず1つを返しますが、その1つが妥当かどうかは別の話です。
判断の理由は返らない
返るのは値と確率だけ
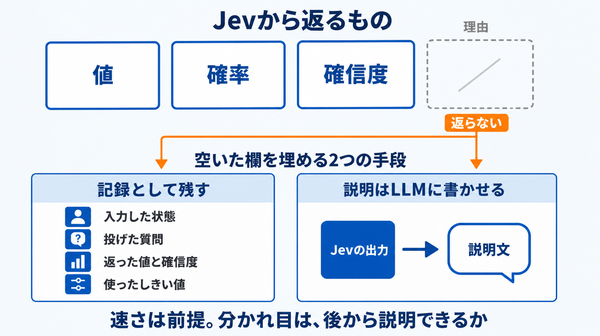
公式ドキュメントに載っている返り値は、選ばれた値、選択肢ごとの確率、確信度です。理由や根拠を入れる欄はありません。だから顧客への回答、監査、稟議、社内からの異議申し立てといった場面で、出せるものが確信度の数字しかない状態が起こります。
説明はLLMに書かせる
まず、次の4点を記録として残します。
- 入力した状態: そのとき渡したデータそのもの
- 投げた質問: 選択肢と尺度の定義を含めて残す
- 返った値と確信度: 選ばれなかった候補の確率も残す
- 使ったしきい値: 何を境に自動で流したか
そのうえで文章での説明が要るなら、Jevの出力をLLMに渡して説明文を書かせる2層の構えです。それはJevの判断理由ではなく、後から付けた説明だという区別は残ります。
確信度で人に回す線を引く
高い判断はそのまま流す
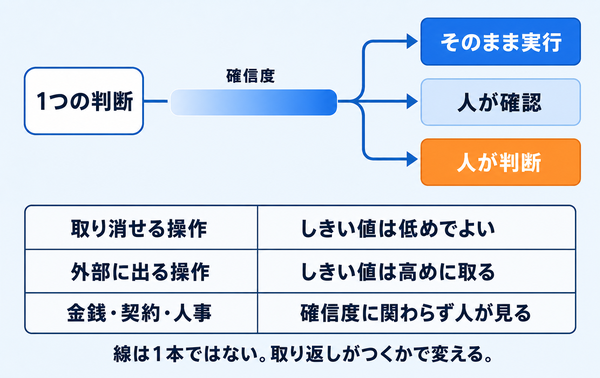
出力には確信度が付き、同社は確信度が高いほど正確だと説明しています。だから任せる範囲を、任せるか任せないかの二択ではなく連続的に決められます。
低い判断は人へ回す
確信度が低い判断は、自動で流さず人の画面に積みます。そこに溜まった件を読むと、選択肢の切り方が業務に合っていない箇所が見つかります。
線は操作ごとに変える
しきい値は1本ではありません。その判断の後ろで動く操作が、どこまで取り返しがつくかで変えます。
- 取り消せる操作: 社内の並び替えやタグ付けは低めでよい
- 外部に出る操作: 顧客に届くものは高めに取る
- 金銭・契約・人事が動く操作: 確信度に関わらず人が見る
自動で実行してよい範囲そのものの設計は別記事で解説しています。
【関連記事】自律型AIエージェントとは?仕組み・活用事例・リスクを解説
向く判断・向かない判断
向くのは短い判断の量産
向くのは、答えの形が決まっていて、数が多い判断です。
- 仕分けと優先度付け: 問い合わせの振り分け、対応順の決定
- 条件を満たすかの判定: 記載漏れの確認、公開してよいかの判定
- 次の1手の選択: 複数の候補から次の処理を選ぶ
向かないのは文章の仕事
書く、要約する、コードを書く、理由を説明する。これらはJevの外です。判定の物差しは「取りうる答えを先に書き切れるか」の一点です。書き切れないなら、まだJevの仕事ではありません。工程を渡せるかどうかを入力の側から判定する考え方もありますが、Jevで問うのは出力の側です。AIに任せる仕事の振り分け方は別記事で解説しています。
【関連記事】AIエージェントと生成AIの違いとは?向く業務と使い分け・組み合わせ方を解説
日本語で使うときの注意
英語が主要な学習言語
公式ドキュメントは、英語が主要な学習言語で現時点で最も精度が良いと明記し、他の言語も扱えるが精度は落ちるとしています。日本語での具体的な精度は公表されていません。
自社の日本語データで測る
ですから日本語で使うなら、自社のデータで測るところから始めます。実際の問い合わせ文や申込内容を20件から30件用意し、人が付けた判断と突き合わせて一致率を見ます。他社が公表した数値を、自社の日本語業務の精度として読み替えないでください。AIの信頼性をどう確かめるかは別記事で解説しています。
【関連記事】AIの信頼性とは?損なう原因・測り方・人の確認の置き方を解説
公式が示す仕様と制約
以下は2026年9月19日時点の公式の記載です。モデル名・入力・コンテキスト長・料金・レート制限はTypeSafe AI公式ドキュメント「モデル」、速度・選択肢の上限・提供状況はTypeSafe AIの発表「システムワンモデルとJevの紹介」に載っています。早期アクセス中のため、導入時に最新の仕様を確認してください。
数値はそのまま業務の切り方に影響します。
- 長い資料は丸ごと渡せない: 要るところだけを抜き出す設計が先に要ります
- 選択肢の上限が分類の粒度を決める: 255を超えるなら分け方を見直します
- レート制限は動的に調整される: 本番の処理量の前提にはしきれません
- 速度と料金は同社の測定値: 自社の処理で測り直します
画像や音声も材料にしたいなら、扱えるモデルが別に必要です。複数の種類のデータを扱うLLMは別記事で解説しています。
【関連記事】マルチモーダルLLMとは?仕組み・代表モデル・活用例を解説
小さく試すときの順番
判断を1つだけ選ぶ
いま人が毎日している判断を1つ選びます。「この問い合わせはどの部署か」のように、答えが短いものが対象です。
選択肢を先に書き出す
その判断で取りうる答えを全部書き出します。ここで書き切れないなら、自動化の前に判断基準が決まっていません。
人の判断と突き合わせる
直近の実データ30件で、人が付けた答えと書き出した選択肢を突き合わせ、どれにも当てはまらなかった件数を数えます。ここまではJevが手元になくても可能です。判断の前後を動かすAIエージェントの選び方は、用途別に整理しています。
【プロの視点】速さより説明できるか
Jevの解説で目立つのは、速度と料金です。同社は同等の水準のLLMと比べて40倍から200倍速いと説明し、出力トークンの料金は無料だとしています。日本語の記事にも、速さの倍率をそのまま見出しに掲げたものがあります。
けれど、見るべきは速さではなく、その判断を後から誰にどう説明するかです。返り値に理由の欄が無いからです。速い判断は、説明できない判断を速く大量に積み上げることでもあります。1日に数千件の仕分けを自動で回した後、顧客から「なぜ自分の申込が後回しになったのか」と聞かれて、出せるものが確信度の数字しかない。そういう状態が起こりえます。
速さと安さは、判断を細かく割って何度も投げられるという前提条件であって、決め手ではありません。決め手は、その判断が外から説明を求められる種類のものかどうかです。社内の下書きの並び替えや一次振り分けのように説明を求められない判断は、確信度だけで回せます。採否、与信、人事、価格のように説明を求められる判断は、値のほかに人が書いた基準と記録が要ります。
明日やる最初の一歩は、自動化したい判断を1つ選び、「理由を聞かれたら何を出すか」を1行書いてみることです。出せるものが無ければ、そこは当面、人が見る場所です。
【waltsu視点】基準を書き直す回数
Jevを入れると、判断の回数は一気に増えます。これまで人が手で捌いていた仕分けが、桁違いの件数で回ります。ただ、回数が増えたこと自体は成果ではありません。
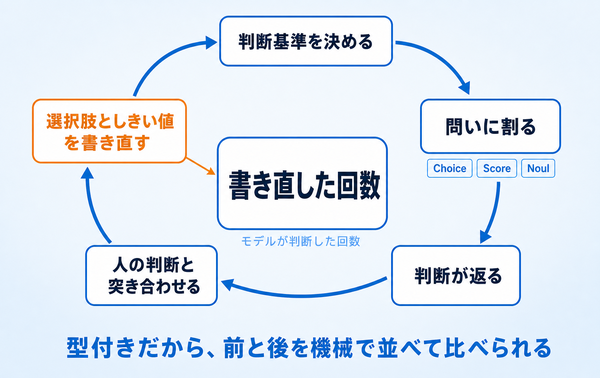
waltsuの考えでは、増やすべきなのはモデルが判断した回数ではなく、人が判断基準を書き直した回数です。Jevは決められた選択肢の中から選ぶだけで、選択肢の切り方も、尺度の目盛りも、人に回すしきい値も、決めるのは人です。判断の質を上げる余地は、モデルの側ではなく書き直しの側にあります。
ここで役立つのが、返るものが型付きの値だという性質です。選択肢を1つ足す前と後で、同じ100件がどう振り分けられたかを機械で並べて比べられます。文章で返ってくるものだと、前と後の違いを読み取るのに人の時間が要ります。書き直した結果を、その日のうちに数字で確かめられます。だから何度も回せます。
つまりJevの価値は、判断が自動化されたことではなく、判断の基準を安く何度も直せるようになったことです。基準が言葉のままで具体的に決まっていない会社では、Jevを入れても選択肢を書き出す段階で止まります。
明日やる最初の一歩は、前の章で数えた「どれにも当てはまらなかった件数」を見て、選択肢を1つ足すか、2つを1つに統合するかを決めることです。これはJevが無くてもできます。
よくある質問
Jevとは簡単にいうと?
あらかじめ決めた選択肢・尺度・真偽の中から、型付きの判断と確率を返すAIモデルです。文章は返しません。
ChatGPTと置き換えられる?
置き換えではありません。文章を書く、要約する、コードを書くといった仕事はJevではできないため、LLMと役割を分けて併用する形になります。
日本語でも精度は出る?
公式ドキュメントは英語が主要な学習言語で最も精度が良いとし、他の言語は精度が落ちるとしています。日本語での具体的な精度は公表されていません。自社の実データで人の判断と突き合わせてから決めてください。
料金はいくらかかる?
2026年9月19日時点の公式の記載では、入力100万トークンあたり0.042ドルで、出力トークンは無料とされています。早期アクセス中の価格です。
いま誰でも使えますか?
2026年9月19日時点では早期アクセスで、ウェイトリストに登録した順に案内されています。一般提供の時期は公表されていません。
この記事の要点
・Jevは文章を返さず、決めた選択肢から型付きの値と確信度を返す
・LLMの置き換えではなく、横に置く判断の層として使う
・形式は保証されるが、選択の正しさと判断の理由は別に用意する
・英語が主要な学習言語なので、日本語は自社データで測ってから決める
まとめ
Jevは、あらかじめ決めた選択肢・尺度・真偽の中から型付きの値と確信度を返すモデルです。文章を返さないぶん、出力をそのままプログラムに渡せます。LLMの置き換えではなく、横に置く判断の層として捉えるのが実際に近いです。
形式が保証されることと、選ばれたものが正しいことは別です。返り値に理由の欄が無いので、説明を求められる判断では、入力した状態・質問・返った値と確信度・しきい値を記録に残す準備が要ります。日本語で使うなら、自社の実データで人の判断と突き合わせてから範囲を決めてください。
手元にJevが無くても、判断を1つ選び、取りうる答えを書き出し、人の判断と突き合わせるところまでは今日から進められます。どの判断をどこまで機械へ渡すか、その線引きに迷う場面が出てきたら、waltsuが業務の切り分けから検証の設計までをご支援します。