 マワルくん
・自社ブログの記事をAIで採点できるか知りたい
・差がつく評価項目の決め方を知りたい
・採点結果をどこまで信用してよいか知りたい
オウンドメディアの記事が100本を超えると、どれから直すかを人が全部読み直して決めるのは難しくなります。waltsuは判断AIのJevに、自社ブログの全134記事を採点させてみました。
要するに、採点は7秒で終わったが、最初は全記事が高得点になって使えず、「記事ごとに差がつく項目」に作り直してから役に立ったという話です。本記事では、その経緯と、点の低い記事の直し方、採点を運用に乗せるときのコツを紹介します。
Jevそのものについては、以下の記事で解説しています。
この記事を監修した人
AIエンジニア
小洞 映ハユル コボラ
この記事のゴール(読了目安 約7分)
AIに記事を採点させるとき、どんな項目を選び、結果をどう読めばよいかを、自社の運用に持ち帰れる。
134記事を7秒で採点した
費用は約0.06米ドル
モデルはTypeSafe AIのJev(jev-1.13.0)で、公式のSDKから呼び出しました。全134本の採点は約7秒で終わり、初回の費用は入力約142万トークンで約0.06米ドルでした。出力は課金の対象外です。
3つのAIを使い分けた
審査項目は、ChatGPTに「自社記事の採点をさせたい。どんな項目でチェックさせれば良いと思う?」と相談し、数回の壁打ちで決めました。採点画面の作成とJevの呼び出しはClaude Codeに任せ、結果を見て悪いところを渡し、直してもらっています。Claude Codeを使ったのは使い慣れているからで、Codexでも問題ありません。
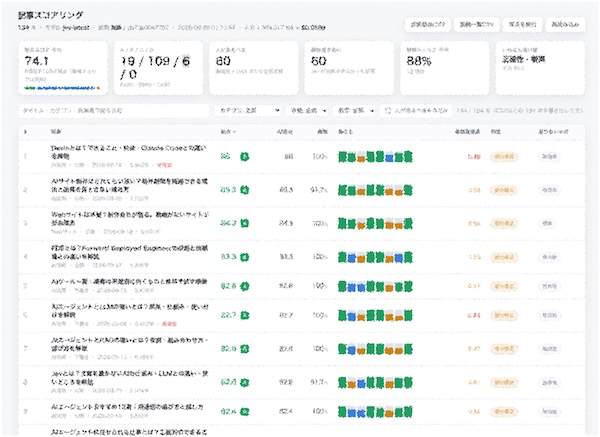
結果は平均74.1点で、A評価19本・B評価109本・C評価6本でした。
最初は全記事が高得点になった
最初の6項目では、「SEOの判断」が平均95.5点、「記事の構成」が89.2点で、ほぼ全記事が90点前後に並びました。判定も134本中128本が「部分修正」です。全記事が高得点では、どれから直すべきか分かりません。
原因は、自社の記事が同じ型で作られていることです。見出しの組み方や問い合わせへの導線のように、型で揃えている項目はどの記事も満たすので、差が出ません。
弱点は独自性と正確性だった
そこで、8項目・100点満点に組み直しました。
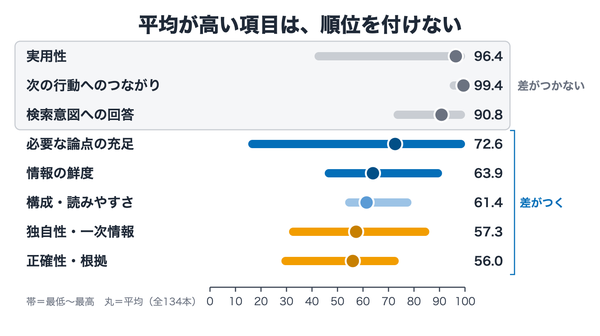
差が出たのは独自性・一次情報(平均57.3)と正確性・根拠(56.0)の2つです。記事ごとに一番点を落とした項目も、独自性が93本、正確性が41本で、全134本がこのどちらかでした。自社にしか書けない話と、主張の根拠。ここが自社記事の弱点だと分かりました。独自性がなぜ検索で評価されるかは別記事で解説しています。
詳細項目も追加した
点数だけでは、何をどう直せばよいかまでは分かりません。そこで記事ごとの詳細画面に、8項目の点と判定、「いちばん足りないもの」、Jevの指摘を並べました。「一次情報がある」「主張に根拠がある」など6つの問いも、はい・いいえで判定させています。
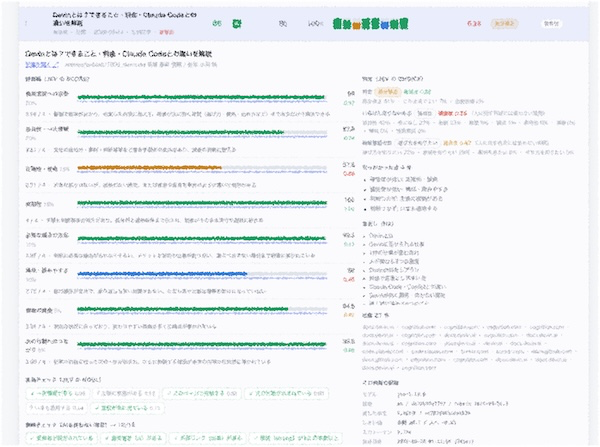
さらにC評価の記事は、点を落とした項目ごとの直し方をClaudeに調べさせ、レビューにまとめました。本文を読ませて、どこが問題で、何を根拠にどう直すかを書かせています。最下位の「Webサイトの歴史」では、次のような指摘が出ました。
- 正確性: FAQの「ホームページ」の説明が誤り寄り。本来は、ブラウザを起動したときに最初に表示されるページを指す
- 正確性: 「スマホ経由が主流」などに出典がなく、事実と意見の区別もない
- 論点の充足: Flashの提供終了(2020年末)など、年代ごとの大きな出来事が抜けている
レビューは「すぐ直す誤り」と「人が判断すること」に分けています。出典の候補もClaudeが挙げますが、貼る前にリンク先の中身を確かめ直す前提です。実際、候補に挙がったCERNの年表のページは、2026年9月29日の確認ではログインしないと開けなくなっていました。
低い6本から直し始めた
C評価の6本は、いちばん点を落とした項目がすべて独自性・一次情報でした。うち4本は、Webサイト、検索エンジン、CRM、Webマーケティングの歴史を扱う記事です。
レビューをもとに、2026年9月26日に6本の改善依頼を記事制作チームへ渡しました。直し方は3段階です。
- 誤り・出典・時点を直す: 誤った説明や出典のない断定は、方針を待たずに直す
- 役割を決めて組み直す: 歴史の記事は統合せずシリーズで残し、年表で終わらせず「今どう判断するか」まで書く。たとえば「Webサイトの歴史」は、自社サイトがどの時代の作りで止まっているかを診断する記事にする
- 再採点で確かめる: 同じ採点で測り直し、総合65点(B評価)以上を目安にする
独自性については、自社の経験が見つからない記事には無理に入れないと決めました。点を上げるために架空の事例を作らないためです。改稿は今も進めている途中で、結果は再採点で確かめます。直す記事の選び方と進め方は別記事で解説しています。
使いこなす4つのコツ
採点を運用に乗せるときに気をつけているのは、次の4つです。
- 点数より順位で見る: 74点が良いか悪いかは判断しない。134本の中で何番目かと、記事ごとに一番点を落とした項目を見る
- 質問は英語で出す: 日本語の質問ではAIの自信を示す確信度が0.25まで落ち、128本が「要確認」になった。英語では0.64・60本で、順位の並びはほぼ同じ(相関0.95)
- 数えれば分かることは聞かない: 見出しの長さのような項目は機械でチェックし、AIの点には混ぜない
- 事実確認は人がやる: Jevに渡しているのは本文と出典のドメインだけで、出典の中身は見ていない。正確性の点が高くても事実が正しいとは限らないので、確信度の低い60本とあわせて人が確かめる
AIの出力をどこまで信用するかは別記事で解説しています。
【プロの視点】全員90点の項目は測れていない
AI採点の解説は「どんな項目を見るか」の列挙で終わりがちです。しかし全記事に流すと、型で揃えた項目は満点付近に集まります。今回も実用性は96.4、次の行動へのつながりは99.4でした。全員が90点を取る項目は、測っていないのと同じです。
項目は「大事かどうか」より「記事ごとに差がつくか」で選びます。まずは手元の10本に点を付け、最高点と最低点の差が小さい項目を1つ外してみてください。
【waltsu視点】答え合わせは検索で
測っているのは「Jevが良いと言う記事」で、「読まれる記事」とは限りません。採点表も仮説で、答え合わせは検索の結果ですると考えています。
独自性の弱さは、「AIで書いた記事が似通ってきた」という社内の声とも重なりました。会議の議事録から自社の話を入れた20本は、独自性が平均76.2、それ以外の114本は54.0です。本数が少なく因果とは言えないため、測り直して確かめます。
採点は7秒で終わるので、直す、測る、検索で確かめる、を何周も回せます。次は点の上位と下位の記事をSearch Consoleの表示回数と並べ、点と検索の結果がずれている記事から採点表を直します。
2026年9月26日には、採点を自社のコンテンツダッシュボードに標準搭載しました。アクセス数と品質の点が同じ画面に並ぶので、ずれた記事をすぐ見つけられます。
よくある質問
AIで記事の品質は採点できる?
できます。ただし項目を置いただけでは差がつきません。差がつく項目に絞り、点は絶対値ではなく順位で読むと、直す順番を決める材料になります。
ChatGPTの採点と何が違う?
Jevは文章で答える代わりに、決めた尺度の点と確信度を返します。文章で答えるAIに採点させる方法と比べると、多くの記事を同じ物差しで並べやすいのが違いです。
日本語の記事でも使える?
日本語の記事をそのまま採点しました。ただし設問は英語にしています。日本語の設問では確信度が0.25まで落ち、134本中128本が要確認になったためです。
採点の点数は信用していい?
絶対値ではなく順位で読むのが前提です。正確性は出典の中身と照合しておらず、確信度の低い60本は人が確認します。
費用と時間はどれくらい?
初回の全件採点は134本で入力約142万トークン・約0.06米ドル、最新の全件採点は約7秒でした。1件あたりの費用の出し方は別記事で解説しています。
この記事の要点
・Jevで134本を7秒で採点できた。ただし最初の項目では全記事が高得点になった
・差がついたのは独自性と正確性。ここが自社記事の弱点だった
・点を落とした項目ごとの直し方はClaudeに調べさせ、C評価の6本から直している
・点は順位で読み、質問は英語で出し、事実確認は人がやる
・項目は「大事か」より「差がつくか」で選ぶ
まとめ
要するに、AIで記事を採点するなら、「大事な項目」より「記事ごとに差がつく項目」を選ぶことです。Jevで134本を7秒で採点できましたが、使える点になったのは、差がつく8項目に作り直し、質問を英語にしてからでした。仕組みを作った担当者は「これからのアップデートやSEOにどんな影響を与えるのかが楽しみ」と話しています。
自社メディアのどの記事から直すか、評価の物差しづくりに迷う場面が出てきたら、waltsuが評価軸の設計から改善の運用までご支援します。