 マワルくん
・音声AIの資料で「フルデュプレックス」という語を見かけた
・電話の自動応答で、AIが話し終わるまで待たされるのを何とかしたい
・GPT-LiveやJ-Moshiが何なのかを知りたい
フルデュプレックス(全二重)はもとは通信の用語です。電話や有線LANの説明で使われてきましたが、2024年ごろから電話の自動応答などを担う音声AIの紹介でも見かけるようになりました。
音声AIでいうフルデュプレックスとは、AIが相手の声を聞きながら話せることです。割り込みに応じられるだけでは全二重とは限らず、導入前に見るのは話す速さより、黙るべきときに黙れるかです。本記事では、半二重との違い、従来の仕組み、代表的なモデル、使いどころと課題を整理します。
この記事を監修した人

マーケティングディレクター
玉城 彪眞タマキ ヒュウマ
この記事のゴール(読了目安 約7分)
単方向・半二重・全二重の違いを例で説明でき、全二重の音声AIでできることとまだ難しいことを分けて、自社の通話で試す前に見る点を決められるようになる。
フルデュプレックスとは
送信と受信を同時に行う方式
フルデュプレックスは送信と受信を同時に行える通信方式で、日本語では全二重と呼びます。身近な例は電話の通話と有線LANです。相手が話している最中でも、こちらの声が届きます。
音声AIでは「聞きながら話す」
音声AIでは、AIが話している最中も相手の声を聞き続ける対話を指します。相づち、話の途中の割り込み、声の重なりといった、人どうしの会話で起きることに応じられます。
単方向・半二重・全二重の違い
違いは通信の向きが1つか2つか、2つなら同時に送れるかで決まります。
人の会話では、相づちや言いかけが重なります。人の会話は全二重で、従来の音声AIの多くは半二重の作りです。
従来の音声AIは半二重
話し終わりを無音で決める
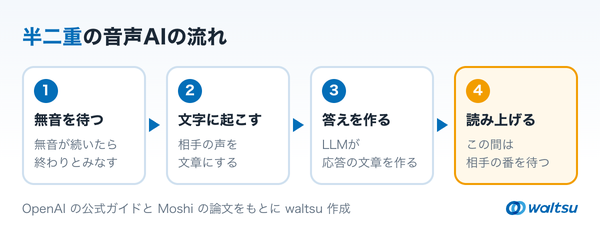
従来の音声AIでは、無音が一定の時間続いたら話し終えたとみなします。OpenAIのRealtime APIでも、無音の長さで区切るか、言葉の内容から話し終わりを見積もるかを選べます。どちらも「相手の番が終わったか」を判定する仕組みです。
読み上げ中は番を待つ
多くの構成では文字起こし、LLMでの応答づくり、読み上げを順に進めます。Moshiの論文は、この直列の構成がやり取りに数秒の遅れを生むと指摘しています。割り込みへの対応も声を検出して読み上げを止める形で後から足されたものです。
そのため、「えーと」と考える間に話を取られたり、相づちのたびにAIが止まったりします。
聞きながら話す仕組み
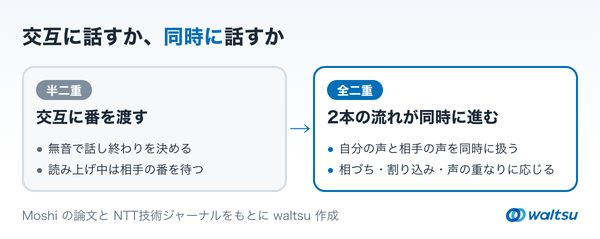
全二重の音声AIは自分の声と相手の声を別々の流れとして同時に扱います。Moshiは2つの流れを並べてモデル化し、明確な番の区切りをなくしました。NTT技術ジャーナルは0.08秒ごとといった短い間隔で解析する例を紹介しています。
AIは短い刻みごとに「いま何を出すか」を決め、話すべきでないときは無音を出します。音声や動画を文字にせず判定するモデルは別記事で解説しています。
【関連記事】Clef-omniとは?音声と動画も判定するCloudflareの判断モデル
難しいのは話す内容と声色、タイミングを同時に決める点です。学習に要る音声対話のデータも、一問一答のデータより集めにくいとされています。
全二重でできること
全二重になると、次の4つができるようになります。
- 割り込み(バージイン): AIの話の途中で、言い直しや訂正を伝えられる
- 相づち: 「はい」「ええ」を返しながら聞き続ける
- 話し終わりの予測: 無音を待たずに、文の終わりを見越して応じる
- 声の重なりへの対応: 同時に話し出したとき、譲るか続けるかを決める
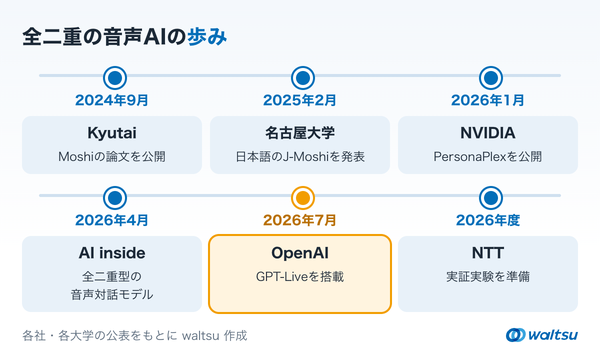
日本語の会話は相づちが多く、半二重のAIとの差が出やすいのがこの部分です。名古屋大学のJ-Moshiも発話の重なりや相づちを含む同時双方向の対話を掲げています。
代表的なモデル
2026年10月時点の主なモデルです。
NTTはコールセンターの自動応対を想定した試作を展示し、2026年度中の実証実験を準備しています(NTT技術ジャーナル2026年5月号)。日本語の全二重AIは研究の公開から実証へ移り始めた段階です。
割り込み対応との違い
声を検出して止める仕組み
Realtime APIは無音で番を区切り、利用者が話し始めたら応答を止める設定を持ちます。割り込めても、AIが待っているのは「番の切れ目」です。
OpenAIも別の方式として扱う
OpenAIの音声エージェントのガイドは、3つの作り方を並べます。
- GPT-Live: 聞きながら同時に話せる。公式が全二重と呼ぶのはこれ
- Realtime API: 番やツール、割り込みをセッションが扱う
- 文字起こし→エージェント→読み上げ: 途中の文章を確かめたいときの構成
製品の説明に「割り込み対応」とあっても、全二重とは限りません。見分けるには、相手が話している最中にAIが相づちを返すかを確かめます。
使いどころ
全二重が向いているのは、相手が言い直したり、言いよどんだりしやすい場面です。
- コールセンター・受付の自動応答: 名前や電話番号の復唱と確認、保留の案内。NTTの展示もこの場面を想定している
- 語学の会話練習: 言いよどむ間に話を取られない
- 車内やスマートスピーカー: 手と目がふさがっていても、声だけで言い直せる
反対に、途中の文章を記録して確かめる必要がある手続きには向きません。コールセンターなど顧客対応での音声AIの活用例は別記事で解説しています。
全二重の音声AIの課題
全二重のAIにはまだ次の課題があります。
- 相づちの打ちすぎ: 多すぎると、聞いていないように受け取られる
- 周りの声への反応: 背景の会話や横の人への話しかけを、割り込みと取り違える。スピーカーから出た自分の声も拾う
- 割り込みの受け付け範囲: 相づちのたびに止まるか、話し続けるか。用途ごとに調整が要る
- ツールを呼ぶ間の扱い: NVIDIAの英語向けモデルNemotronLabs VoiceChatは、ツールの実行中は利用者が割り込めないと既知の制約に書いている
全二重にしても、周りの音の扱いは別に詰める必要があります。
【プロの視点】速さより黙れるかを見る
音声AIを比べるとき、話題は「応答まで何ミリ秒か」に集まりがちです。速さは数字で並べやすいからです。
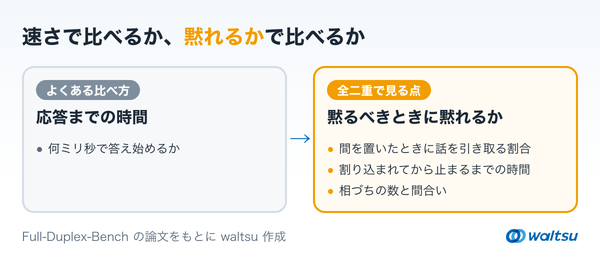
ただ全二重では、AIが「いま話すか、黙るか」を判断する回数が増えます。評価用のベンチマークFull-Duplex-Benchは、相手が間を置いたときにAIが話を引き取ってしまう割合(Takeover Rate)を測り、低いほど良いとしています。後の版では割り込まれて止まるまでの時間も測定の対象です。見るべきは黙るべきときに黙れるかです。
明日の一歩として、自社の通話録音から、言いよどみと言い直しの場面を10か所選んでください。そこでAIが黙るべきか話すべきかを先に決めておきましょう。そうすれば、どのモデルも同じ基準で比べられます。
【waltsu視点】割り込みの台本を先に作る
全二重のモデルは相手の話し方しだいで結果が変わります。そこで勧めたいのが、言いよどみや言い直し、背景の声を入れた短い台本を先に用意することです。台本があれば、モデルや設定を替えても同じ条件で何度でも比べられ、1回の試しが軽くなります。
半二重のままでも、無音の長さや割り込みの設定を詰めれば困りごとが消えることがあります。まず今の仕組みで台本を流し、困りごとを測ってから替えるかを決める順なら、試す回数を無駄にしません。
明日の一歩は「言い直し」「相づち」「横の人への声かけ」の3場面を、それぞれ30秒の台本に書くことです。
よくある質問
フルデュプレックスとは簡単にいうと?
送信と受信を同時に行える通信方式です。音声AIでは聞きながら話せる対話を指します。
半二重との違いは?
半二重は送信と受信を交互に切り替えます。トランシーバーが半二重、電話が全二重の例です。
割り込めるAIは全部全二重?
そうとは限りません。声を検出して読み上げを止める仕組みでも、割り込みには応じられます。
日本語の全二重AIはある?
あります。名古屋大学が2025年にJ-Moshiを公開し、2026年にはAI inside社も発表しました。
コールセンターにすぐ使える?
2026年10月時点では、NTTも実証実験を準備している段階です。自社の通話録音や台本で試してから判断してください。
この記事の要点
・フルデュプレックス(全二重)は送信と受信を同時に行える通信方式
・音声AIでは聞きながら話し、相づちや割り込みに応じる対話を指す
・割り込めても、無音で番を区切る仕組みなら全二重とは限らない
・導入前は応答の速さより、黙るべきときに黙れるかを確かめる
まとめ
フルデュプレックスは送信と受信を同時に行う通信の方式です。音声AIでは聞きながら話すことで人の会話に近づきます。2024年のMoshiに続き、2026年にはGPT-Liveや日本語のモデルも出てきました。
一方で、相づちの多さや周りの声への反応など、試さないと分からない課題も残ります。音声AIを電話応対や受付にどう組み込むか迷ったら、waltsuが試し方の設計からご支援します。