 マワルくん
・マルチモーダルAIの事例を知りたい
・画像や音声のデータを活用したい
・テキスト中心のAI活用から進みたい
「マルチモーダルAI」という言葉は聞くものの、実際に何に使われているのか、テキストの生成AIと何が違うのかが分からない、という声をよく聞きます。生成AIを導入したものの、文章作成・要約から先へ進めていない企業ほど、次の一手として気になる領域のはずです。
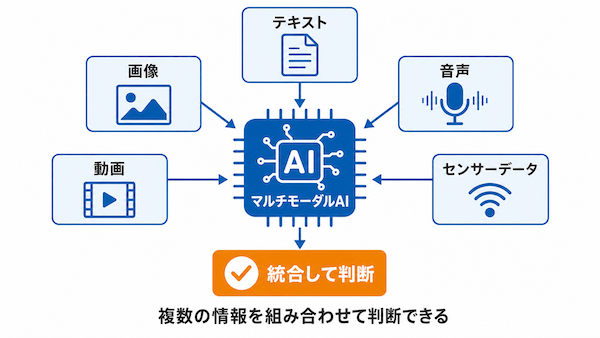
マルチモーダルAIとは、テキスト・画像・音声・動画・センサーデータなど、複数の種類の情報をまとめて理解・処理できるAIです。価値の中心は「画像も音声も扱えること」そのものではありません。現実の仕事は、見る・聞く・読む・数値を見る・過去と比べる、という複数情報の組み合わせで成り立つものです。マルチモーダルAIの価値は、この組み合わせを扱えることで、AIが現場の仕事に近づくことにあります。本記事では、業界別の活用例を「何と何のデータを組み合わせているか」の視点で整理し、メリット・課題、導入の進め方まで解説します。
この記事のゴール(読了目安 約9分)
自社が持つテキスト・画像・音声・動画・センサーデータなどを棚卸しし、どのデータを組み合わせればどの業務をAI化できるか考えられるようになる。
マルチモーダルAIとは
複数の情報を扱うAI
モーダル(モダリティ)とは、テキスト・画像・音声・動画といった情報の種類のことです。マルチモーダルAIは、これらを組み合わせて入力し、まとめて理解・処理できるAIを指します。「この設備の写真と異音の録音から、故障の可能性を教えて」のように、種類の異なる情報をひとつの質問として渡せるのが特徴です。総務省の情報通信白書も、生成AIを「テキスト、画像、映像等の多様な形式(マルチモーダル)のアウトプットが取得できるもの」と説明し、マルチモーダル機能によってAIが「様々なデータ形式や入力に対応し、多様なタスクを同時に処理できる」ようになったと整理しています(総務省「令和6年版 情報通信白書」生成AIの急速な進化と普及)。
従来のAIとの違い
従来は、文章を扱うテキストAI、画像を認識する画像AI、音声を文字にする音声AIと、1種類の情報ごとにAIが分かれていました(シングルモーダル)。マルチモーダルAIはこれらを統合し、複数の情報を突き合わせて判断できます。人間にたとえるなら、読む・見る・聞くをばらばらに行うのではなく、五感を組み合わせて状況を判断する働きに近づいたといえます。
マルチモーダルAIでできること
できることを整理すると、画像を理解する、音声を理解する、動画を理解する、複数のデータを組み合わせる、組み合わせから判断する、の5つです。
重要なのは5つ目です。画像単体・音声単体の認識は従来のAIでもできました。マルチモーダルAIが変えたのは、「映像+数値」「音声+顧客情報」のように組み合わせて判断できるようになったことです。以降の業界別の例は、すべて「何と何を組み合わせたか」に注目して読んでください。
製造業の活用例
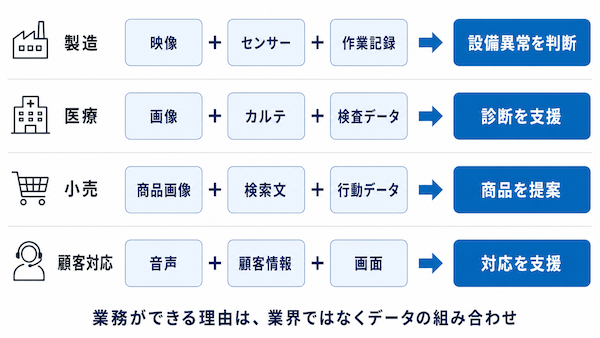
製造現場では、カメラ映像+温度・振動などのセンサーデータ+作業記録の組み合わせが典型です。
外観の画像だけでは判別しきれない不良を、製造条件のデータと突き合わせて検知する。設備の映像と振動データと過去の保全記録を組み合わせ、異常の兆候を多面的に捉える。作業者が現場の写真を撮って質問すると、マニュアルと図面を参照して手順を案内する。いずれも「目視+計器+経験」で行っていた仕事の構造をそのままAIで再現した形です。製造業でのAI活用の広がりは、AIエージェントの記事でも解説しています。
医療の活用例
医療では、医用画像+カルテの記録+検査データ+病歴の組み合わせによる診断支援の研究が進んでいます。医学誌Nature Medicineの総説は、大規模バイオバンク・電子カルテ・医用画像・ウェアラブル型センサー・低コスト化したゲノム解析といったデータが揃ってきたことで、医療でマルチモーダルAIに取り組む条件が整ったと整理しています(Acosta ら「Multimodal biomedical AI」Nature Medicine 28巻 1773-1784頁(2022年))。
画像単体の読影支援は以前からありましたが、マルチモーダル化によって、画像所見と数値データと経過記録を突き合わせた、より包括的な患者理解を支援する方向へ発展しています。なお医療は判断の影響が大きい領域のため、AIはあくまで支援であり、診断の主体は医師に残る前提で活用が進んでいます。
小売・ECの活用例
小売・ECでは、商品画像+検索テキスト+購買履歴+行動データの組み合わせが中心です。
「こんな雰囲気の服」といった曖昧な言葉と画像を組み合わせた商品検索、閲覧・購買履歴と商品画像を突き合わせた推薦、店頭カメラの映像と販売データを組み合わせた売場改善などに使われています。テキストだけでは拾えなかった「言葉にしにくい好み」を扱えるのが、この領域でのマルチモーダル化の価値です。
自動車の活用例
自動運転は、マルチモーダルAIの代表例です。カメラ映像+各種センサー+位置情報+地図データを統合し、周囲の状況をリアルタイムに判断します。内閣府の交通安全白書は、歩行者や自転車が往来する一般道では車載センサーからの情報のみで自動運転を実現するのは難しく、信号情報や道路交通情報といった道路交通インフラ側から得る情報が有用だとしています。あわせて、高精度3次元地図を含むダイナミックマップの整備も進められてきました(内閣府「令和2年交通安全白書」トピックス 先端技術について)。
車内でも、音声の指示+車両データ+周辺情報を組み合わせた車内アシスタントや、ドライバーの状態を映像から検知する安全支援が実用化されています。1種類の情報だけでは安全な判断ができないという点で、複数情報の統合が欠かせない領域です。
マーケティングの活用例
マーケティングでは、テキスト+画像+動画+音声を組み合わせたクリエイティブ制作と顧客理解が主な用途です。
商品情報と過去の広告素材から複数パターンのクリエイティブ案を作る、動画広告の映像・音声・テキストをまとめて分析して効果の要因を探る、レビューの文章と投稿画像を合わせて顧客の使い方を理解する、といった使い方が広がっています。制作物の量産だけでなく、非テキストの顧客データを分析対象にできることが実務上の変化です。
顧客対応・防犯の活用例
顧客対応では、通話音声+会話内容+顧客情報+操作画面を組み合わせ、コールセンターの対応支援やオンライン接客に使われています。音声の内容だけでなく、顧客が見ている画面や過去のやり取りまで踏まえた支援ができる点が、テキストチャットボットとの違いです。
防犯・監視では、映像+音声+センサー情報を組み合わせた異常検知が使われています。映像単体では判別しづらい状況を、音や周辺情報と合わせて判断する形です。
主なマルチモーダルAI
代表的なサービスとしては、ChatGPT、Gemini、Claudeなどが挙げられます。いずれもテキストに加えて画像などの入力に対応を広げており、日常業務で使う汎用AIが、すでにマルチモーダルAIになっています。画像を入力として渡せることは、各社が公式ドキュメントで説明しています(OpenAI「Images and vision」/Google「画像の理解」Gemini API ドキュメント/Anthropic「Vision」)。
つまり、マルチモーダルAIの活用は特別なシステム開発から始まるとは限りません。いま使っている生成AIに、写真や資料の画像を渡すことから始められます。各サービスの対応範囲は更新が速いため、本記事では機能の詳細には踏み込みません。導入時に最新の提供状況を確認してください。
導入のメリット・課題
メリットは、判断材料を増やせる、現場業務に使いやすい、分析の精度を高めやすい、業務の自動化範囲を広げられる、の4つです。
一方、課題もあります。以下の表にまとめます。
とくに個人情報は、テキスト以上に扱いが難しい領域です。個人情報保護法は「個人識別符号が含まれるもの」を個人情報と定めており(e-Gov法令検索「個人情報の保護に関する法律」第2条)、その施行令は、顔の骨格及び皮膚の色などによって定まる容貌や、発声の際の声帯の振動・声道の形状などを、特定の個人を識別できる符号に変換したものを個人識別符号として挙げています(e-Gov法令検索「個人情報の保護に関する法律施行令」第1条)。カメラ映像や通話音声からこうしたデータを作れば、その情報は個人情報として扱われます。利用ルールは先に整備してください。社内ルールの作り方は、生成AIガイドラインの記事で解説しています。
導入の進め方
進め方は次の5ステップです。
- STEP1 業務を選ぶ: 「見る・聞く」が判断材料になっている業務を候補にする
- STEP2 データを整理する: 画像・音声・動画・センサーなど、すでに持っている非テキストデータを棚卸しする
- STEP3 組み合わせを考える: どのデータとどのデータを突き合わせれば判断できるかを設計する
- STEP4 小さく検証する: 1業務・1データ組み合わせで精度と効果を確かめる
- STEP5 業務に組み込む: 確認工程と利用ルールを整えたうえで、日常業務のフローへ入れる
【プロの視点】事例は「組み合わせ」で読む
マルチモーダルAIの事例記事は、業界名で並べられることがほとんどです。しかし「製造で使える」「医療で使える」という読み方では、自社への転用は進みません。
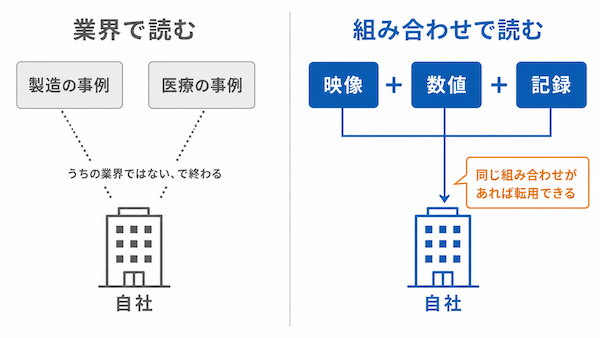
本記事で見てきたとおり、どの事例も構造は同じです。製造は映像+センサー+作業記録で設備を判断し、医療は画像+記録+検査データで診断を支援し、小売は画像+検索文+行動データで商品を提案し、顧客対応は音声+顧客情報+画面で対応を支援する。業務ができるようになった理由は業界ではなく、データの組み合わせにあります。
だから事例を読むときは、「何と何のデータを組み合わせたから、その判断ができるようになったのか」を抽出してください。同じ組み合わせが自社にあれば、業界が違っても転用できます。逆に、組み合わせるべきデータが揃っていなければ、同じ業界の事例でも再現できません。
【waltsu視点】非テキストデータを棚卸しする
生成AIを導入した企業の多くが、文章作成・要約・議事録というテキスト中心の活用で止まっています。次の一手が見えない理由は、AIの能力ではなく、自社がすでに持っている非テキストデータを資産として数えていないことにあります。
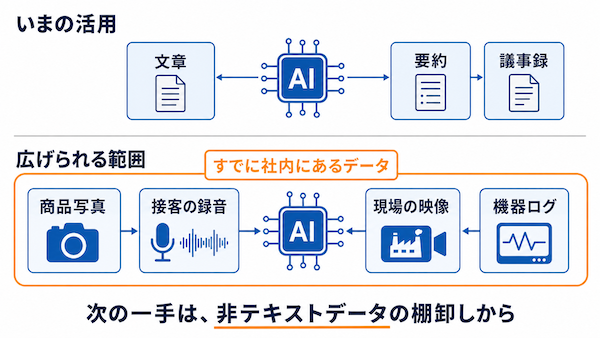
商品や施工現場の写真、接客や商談の録音、店舗やショールームの映像、機器のログ。どの会社にも、テキストになっていないデータが日々たまっています。マーケティングの現場でも、広告画像・LPのスクリーンショット・動画素材・顧客の声の録音は、これまで人が個別に見るしかない情報でした。
waltsuでも、テキストだけでなく画像や資料をそのままAIに渡して分析・制作の材料にする運用へ広げたことで、扱える情報が増え、試せる打ち手の幅と回数が増えました。始め方は大がかりなシステム開発ではありません。まず自社の非テキストデータを棚卸しし、いま使っている生成AIに1枚の画像を渡すことからです。
よくある質問
マルチモーダルAIとは簡単にいうと?
テキスト・画像・音声・動画・センサーデータなど、複数の種類の情報をまとめて理解・処理できるAIです。種類の異なる情報を組み合わせて判断できる点に特徴があります。
生成AIとの違いは?
対立する概念ではありません。生成AIのうち、テキスト以外の情報も入力・理解できるものがマルチモーダルAIです。現在の主要な生成AIサービスは、多くがマルチモーダル化しています。
どんな業界で使われていますか?
製造(映像+センサーによる検査・異常検知)、医療(画像+記録による診断支援)、小売(画像+行動データによる検索・推薦)、自動車(自動運転)、マーケティング、顧客対応、防犯などで使われています。
ChatGPTもマルチモーダルAIですか?
はい。ChatGPTをはじめ、GeminiやClaudeなどの主要サービスは、テキストに加えて画像などの入力に対応を広げており、マルチモーダルAIの一種です。
企業は何から始めればいいですか?
自社の非テキストデータ(写真・録音・映像・ログ)の棚卸しから始めます。そのうえで「見る・聞く」が判断材料になっている業務を1つ選び、いま使っている生成AIに画像を渡すところから試すのが現実的です。
まとめ
この記事の要点
・マルチモーダルAIは、テキスト・画像・音声・動画・センサーデータを組み合わせて判断できるAI
・価値は「画像も扱えること」ではなく、複数情報の組み合わせで成り立つ現場の仕事に近づけること
・事例は業界ではなく「何と何のデータを組み合わせたか」で読むと、自社へ転用できる
・始め方は非テキストデータの棚卸しと、いま使っている生成AIに画像を渡すことから
マルチモーダルAIとは、複数の種類の情報をまとめて理解・処理できるAIです。製造の検査・異常検知、医療の診断支援、小売の検索・推薦、自動運転、マーケティング、顧客対応、防犯まで、活用はすでに幅広い業界で進んでいます。そして共通するのは、業務ができるようになった理由が「データの組み合わせ」にあることです。
導入は、業務を選び、非テキストデータを棚卸しし、組み合わせを設計し、小さく検証して業務に組み込む、の5ステップで進めてください。「生成AIを導入したが、文章作成や要約から先に進めていない」「画像・音声・動画のデータを業務に活かしたい」という場合は、waltsuが自社データの棚卸しからAI活用の業務設計までご支援します。