 マワルくん
・マルチモーダルLLMの意味を知りたい
・LLMとの違いを整理したい
・画像や音声もAIで扱いたい
生成AIの解説で「マルチモーダルLLM」という言葉を見かける機会が増えました。LLM(大規模言語モデル)は聞いたことがある。マルチモーダルAIもなんとなく分かる。でも「マルチモーダルLLM」となると、どちらと何が違うのか説明しにくい——そんな状態の方が多いはずです。
マルチモーダルLLMとは、テキストに加えて、画像・音声・動画などの複数の種類の情報(モダリティ)を入力として受け取り、まとめて理解・推論できる大規模モデルのことです。MLLM、LMM(大規模マルチモーダルモデル)などの表記もありますが、本記事では「マルチモーダルLLM」に統一します。この技術の価値は、「画像も入力できるようになった」ことだけではありません。本質は、これまで人がAIに渡す前に行っていた「状況を文章に変換する」という工程を小さくし、現実の情報を直接AIへ渡せるようにしたこと。本記事では、従来のLLMやマルチモーダルAIとの違い、仕組み、代表的なモデル、活用例、導入の考え方まで解説します。
この記事のゴール(読了目安 約9分)
マルチモーダルLLMを「画像も見られるLLM」ではなく「複数種類の情報を統合して文脈を理解するモデル」として理解し、自社のどの業務に必要かを判断できるようになる。
マルチモーダルLLMとは
複数の情報を扱うLLM
モダリティとは、テキスト・画像・音声・動画といった情報の種類のことです。従来のLLMが主にテキストの入出力を前提としてきたのに対し、マルチモーダルLLMは複数のモダリティを直接入力でき、それらを組み合わせて理解・推論します。「この写真の設備の異常箇所を、マニュアルと照らして説明して」のように、種類の違う情報をひとつの質問としてまとめて渡せるのが特徴です。
MLLM・LMMという表記
この分野では、Multimodal LLM(MLLM)、Large Multimodal Model(LMM)、大規模マルチモーダルモデルなど、複数の表記が使われています。研究側でも呼び方は分かれており、arXiv「A Survey on Multimodal Large Language Models」はMLLM、arXiv「Improved Baselines with Visual Instruction Tuning」はLMMという表記を採っています。指しているものはおおむね同じで、複数モダリティを扱える大規模モデルのことです。表記の揺れに惑わされず、「テキスト以外も直接理解できる大規模モデル」と押さえておけば実務上は困りません。
従来のLLMとの違い
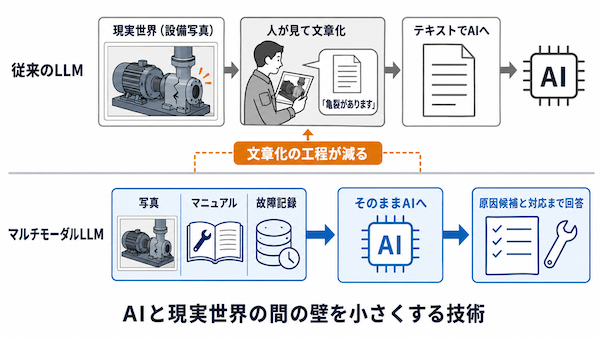
従来のLLMは、テキストで受け取り、テキストで返すモデルでした。画像や音声の内容を扱いたければ、人間が見て・聞いて、内容を文章に変換してから入力する必要がありました。
マルチモーダルLLMは、この変換を省いて現実の情報を直接受け取ります。たとえば工場の設備点検なら、従来は「モーター付近に亀裂があります」と人が文章化してからAIに相談していたものが、設備の写真とマニュアルと過去の故障記録をそのまま渡し、「何が起きているか」「原因候補は何か」まで考えさせられるようになりました。AIと現実世界の間にあった「文章化」という壁が小さくなった——これが実務上の最大の変化です。
マルチモーダルAIとの違い
似た用語との関係を整理します。以下の表にまとめます。
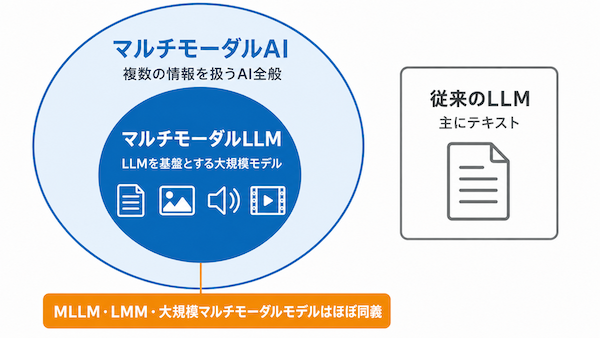
マルチモーダルAIが「複数の情報を扱うAI」の総称であるのに対し、マルチモーダルLLMはその一種で、LLM系の大規模モデルを指します。ただし現在の主要な生成AIサービスはほぼマルチモーダル化しているため、両者の境界は実務上ほとんど意識されなくなりつつあります。業界別の活用パターンは、マルチモーダルAIの事例記事で詳しく解説しています。
扱える情報と できること
扱えるモダリティは、テキスト、画像、音声、動画、そしてコードや図表などのデータです(対応範囲はモデルにより異なります)。
できることの典型は6つあります。画像の内容を説明する、図表入りの資料を読み取る、音声で自然に対話する、動画の内容を理解する、画面を見ながら操作を支援する、複数のデータをまとめて分析する。共通するのは、「見る・聞く・読む」が混ざった、人間の実務に近い形の仕事ができるようになったことです。
マルチモーダルLLMの仕組み
内部の動きは、5つの工程に整理できます。
- 情報を読み取る: 画像・音声・テキストなど、各モダリティを受け取る
- 特徴を数値化する: モダリティごとの内容を、モデルが扱える数値表現(ベクトル)へ変換する
- 共通の空間で統合する: 種類の違う情報を、意味を比較できる共通の表現空間へそろえる
- 推論する: 統合した情報をもとに、関係や文脈を読み解く
- 回答を生成する: 理解した内容を、テキストなどの形で出力する
鍵は3つ目です。画像の「犬」と、テキストの「犬」を、同じ意味として扱える共通の空間に置く。これができるため、「この写真は何?」というテキストの質問と画像を関連づけて答えられます。この考え方の代表例が、画像用と文章用のエンコーダを同時に学習させ、画像と文章を同一の埋め込み空間へ対応づけるarXiv「Learning Transferable Visual Models From Natural Language Supervision」(CLIP)です。仕組みの詳細を覚える必要はありませんが、「別々に認識してから合体」ではなく「共通の意味空間で統合」している、という理解が本質に近い捉え方です。
代表的なモデル
代表的なところでは、GoogleのGeminiシリーズがあります。Googleは公式ドキュメントで、Geminiを「はじめからマルチモーダルに作られている(built to be multimodal from the ground up)」モデルと説明し、すべてのバージョンがマルチモーダルであるとしています(Google「Image understanding|Gemini API」)。動画についても、映像と音声の両方のストリームから内容を理解できると案内されています(Google「Video understanding|Gemini API」)。OpenAIのGPTシリーズも画像を入力して解析できると案内されており(OpenAI「Images and vision」)、AnthropicのClaudeも画像の送り方が公式ドキュメントに示されています(Anthropic「Vision」)。
つまり、普段の業務で使われている主要な生成AIサービスは、すでにマルチモーダルLLMです。特別なシステムを構築しなくても、いま使っているAIに写真や資料を渡すことから活用は始められます。なお、各モデルの対応モダリティ・機能の詳細は更新が非常に速いため、本記事では踏み込みません。導入時に最新の提供状況を確認してください。
業務での活用例
業務での使われ方を2つの領域で見てみます。
製造業では、設備の写真+センサーデータ+マニュアル+過去の故障記録を組み合わせた点検・品質管理・作業支援が典型です。マーケティングでは、広告画像・動画・テキスト・成果データをまとめて分析するクリエイティブ改善や、レビューの文章と投稿画像を合わせた顧客理解が広がっています。
いずれも「どの業界か」より、「何と何のデータを組み合わせたか」で読むのが転用のコツです。製造・医療・小売など業界別の詳しい活用パターンは、マルチモーダルAIの事例記事で解説しています。
AIエージェント・ロボットとの関係
マルチモーダルLLMは、AIの「理解する能力」を担います。見る・聞く・読む・状況を把握する。一方、AIエージェントは「仕事を進める能力」を担います。計画し、判断し、ツールを使い、実行する。
この2つが組み合わさると、「画面や現場の状況を理解しながら、自律的に業務を進めるAI」が成立します。さらにその先にあるのが、見たものと言葉での指示の理解を、そのままロボットの動作へつなげる研究です。arXiv「RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control」は、ロボットの動作をテキストのトークンとして表現することで視覚・言語モデルを制御へ転用し、この種のモデルをvision-language-action(VLA)モデルと呼んでいます。マルチモーダルLLMは、AIが現実世界とつながるための入口にあたる技術です。AIエージェントの基本は、別記事で解説しています。
メリット・課題
メリットは、AIへ渡せる情報量が増える、文脈を理解しやすくなる、対象にできる業務が広がる、音声・画像を交えた自然な対話ができる、の4つです。
一方、課題もあります。以下の表にまとめます。
導入時のポイント
進め方は5つです。目的から考える(技術からではなく課題から)、必要なモダリティを絞る(全部を扱おうとしない)、データ品質を確認する(ぼやけた画像・雑音だらけの音声では精度が出ない)、人の確認を残す、小さく検証する。
とくに2つ目が重要です。次章で述べるとおり、すべての業務にマルチモーダルが必要なわけではありません。
【プロの視点】本質は入力の数でなく統合
マルチモーダルLLMは「AIの目と耳」と説明されがちです。分かりやすい比喩ですが、本質を捉えるには少し足りません。
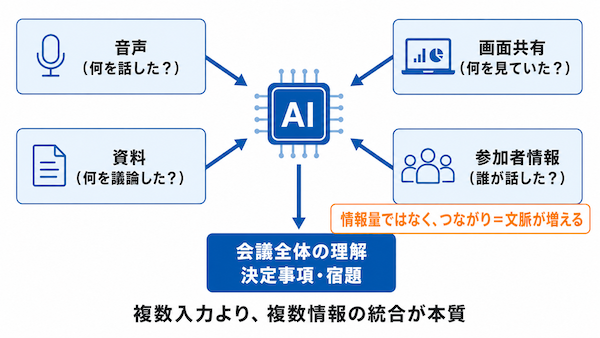
価値の中心は、画像を見られること・音声を聞けることではなく、種類の違う情報同士を関連づけて、文脈を理解できることにあります。たとえば会議の理解なら、音声から「何を話したか」、画面共有から「何を見ていたか」、資料から「何を議論していたか」、参加者情報から「誰が話したか」。1つずつは従来のAIでも認識できました。マルチモーダルLLMが変えたのは、これらを統合して「この会議で何が決まり、何が宿題なのか」という全体理解へ到達できることです。
モダリティが増えると、情報量が増えるのではありません。情報同士のつながり——文脈が増えるのです。だから活用を考えるときも、「画像を読ませたい」ではなく「どの情報とどの情報を突き合わせれば、この業務の判断ができるか」から発想してください。
【waltsu視点】すべてに使う必要はない
新しい技術が出ると、「全部これで置き換えるべきか」という発想になりがちです。マルチモーダルLLMについての答えは、明確にノーです。
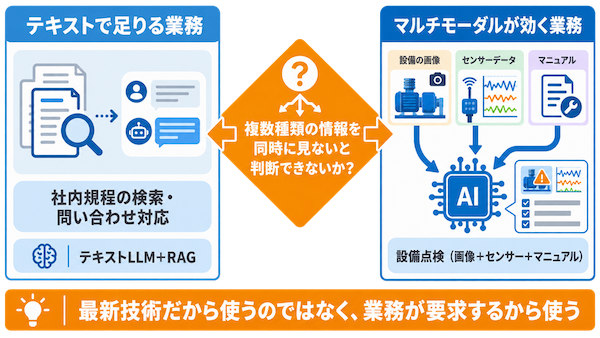
たとえば社内規程の検索・問い合わせ対応なら、テキストのLLMとRAGの組み合わせで十分な場合が多く、マルチモーダル化はコストを増やすだけかもしれません。一方、設備点検のように画像・センサー・マニュアルを同時に見る必要がある業務なら、マルチモーダルLLMが役立ちます。判断基準はシンプルで、「その業務は、複数種類の情報を同時に見ないと判断できないか」です。
waltsuがAI活用の支援で勧めているのも、この見極めからです。テキストで足りる業務はテキストで速く回し、複数情報の統合が必要な業務にだけマルチモーダルを使う。技術を絞るほど1つあたりの検証は速くなり、同じ期間で試せる業務の数が増えます。最新技術だから使うのではなく、業務が要求するから使う。この順番は、どの技術でも変わりません。
よくある質問
マルチモーダルLLMとは簡単にいうと?
テキストに加えて画像・音声・動画などを直接入力でき、それらを統合して理解・推論できる大規模モデルです。MLLM、LMM、大規模マルチモーダルモデルなどの表記もほぼ同じ意味で使われています。
LLMとの違いは?
従来のLLMは主にテキストの入出力が前提です。マルチモーダルLLMは画像・音声などを直接扱えるため、人が状況を文章に変換してから入力する工程を減らせます。
マルチモーダルAIとの違いは?
マルチモーダルAIは複数種類の情報を扱うAI全般を指す広い概念で、マルチモーダルLLMはそのうちLLMを基盤とする大規模モデルです。実務上、両者の境界はあまり意識されなくなっています。
ChatGPTもマルチモーダルLLMですか?
はい。ChatGPTのほか、GeminiやClaudeなど主要な生成AIサービスは、テキストに加えて画像などの入力に対応を広げており、マルチモーダルLLMに含まれます。
どんな業務に向いていますか?
図面と現場写真の照合、資料の読み取り、映像・音声を含む記録の分析など、複数種類の情報を同時に見ないと判断できない業務に向いています。テキストだけで足りる業務は、従来のLLMで十分な場合があります。
まとめ
この記事の要点
・マルチモーダルLLMは、テキスト・画像・音声・動画を直接入力し、統合して理解できる大規模モデル
・実務上の価値は「状況を文章化する工程」を減らし、現実の情報を直接AIへ渡せるようになったこと
・本質は入力の種類が増えることではなく、情報同士を関連づけて文脈を理解できること
・すべての業務に必要なわけではない。「複数情報を同時に見る必要があるか」で判断する
マルチモーダルLLMとは、複数のモダリティを直接入力し、共通の意味空間で統合して理解・推論する大規模モデルです。主要な生成AIサービスはすでにこの能力を持っており、活用は特別な開発からではなく、いま使っているAIに画像や資料を渡すことから始められます。
導入の判断軸は、技術の新しさではなく業務の要求です。複数種類の情報を同時に見ないと判断できない業務を見つけ、必要なモダリティを絞り、小さく検証する。「文章・チャット中心の活用から、画像・音声・現場データまで広げたい」という場合は、waltsuが業務の見極めからAI活用の設計までご支援します。