 マワルくん
・フィジカルAIという言葉を最近知った
・生成AIがなぜロボットにつながるのか知りたい
・製造・物流などでロボット導入を検討している
生成AIは、文章、画像、コード、分析といった「デジタル空間の仕事」を変えてきました。次の変化として注目されているのがフィジカルAIです。ヒューマノイドのデモが話題になりますが、「従来のロボットと何が違うのか」を説明できる人はまだ多くありません。
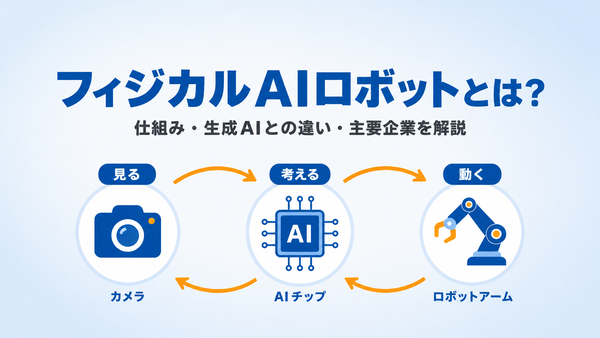
フィジカルAIとは、AIがカメラやセンサーで現実世界を認識・理解・推論し、ロボットなどの身体を使って物理的に行動する技術です。その本質は、ロボットが賢くなることより、プログラムしなくても仕事を覚えられるようになることにあります。本記事では、従来ロボット・生成AI・AIエージェントとの違い、VLAや世界モデルの仕組み、主要企業、産業別の活用、課題までを解説します。
この記事のゴール(読了目安 約10分)
フィジカルAIをヒューマノイドと同一視せず、見る・考える・動くの基本構造とVLA・世界モデル・シミュレーションの役割を理解し、どの産業から普及しそうかまで説明できるようになる。
フィジカルAIとは
見て、考えて、動くAI
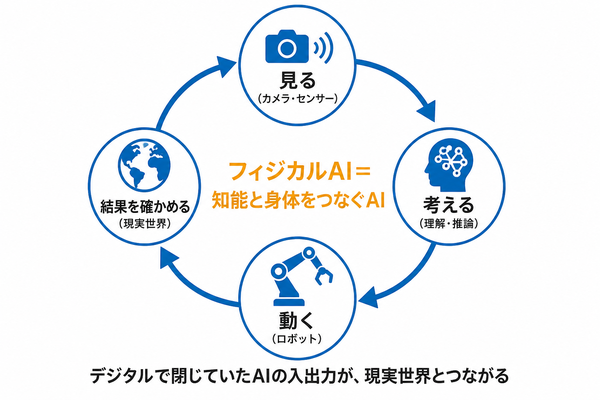
フィジカルAIとは、カメラやセンサーから現実世界の情報を取り込み、物体・空間・物理法則を理解・推論したうえで、ロボットや機械を動かして行動するAIです。NVIDIAも、自律システムが物理世界を認識・理解・推論し、複雑な行動を実行できるようにするAIと説明しています。
動きの基本は循環です。見る、考える、動く、結果を見る、また考える。この繰り返しで環境の変化に対応します。デジタルの中で完結していたAIの入出力が、現実世界とつながった形と言えます。
ヒューマノイドだけを指さない
人型はフィジカルAIの代表例ですが、対象はもっと広く、産業用アーム、搬送ロボット、自動運転車、手術支援ロボット、自律建機なども含む概念です。研究分野には以前からEmbodied AI(身体化AI)という近い概念があり、フィジカルAIはその産業応用を意識した言葉として使われる場面が増えています。厳密な境界はなく、同義で使われることもあります。
従来ロボットとの違い
従来の産業用ロボットは、決められた位置の部品に決められた動作を高速・高精度で繰り返すことが得意です。「座標Aの部品を取り、座標Bへ置く」を事前にプログラムして動かします。正確ですが、部品の位置がずれる、知らない形の物が来る、人が入ってくるといった変化への対応は苦手でした。
フィジカルAIロボットは、カメラで対象を見つけ、位置と形状を認識し、持ち方を判断して行動します。位置が毎回違っても対応可能です。国内メーカーもこの変化を、決められた動作の再現から、現実を認識して自律判断するロボットへの進化と説明しています。一言でいえば、自動化から自律化への移行です。
生成AI・AIエージェントとの違い
関係を以下の表にまとめます。
生成AIに「コップをテーブルへ置いて」と頼めば方法を説明しますが、フィジカルAIはコップを見て、手を伸ばし、持ち、運び、置くまで実行します。3つは対立ではなく融合の関係で、AIエージェントが計画しフィジカルAIがロボットを動かす組み合わせが今後の基本形です。生成AIとAIエージェントの違いは別記事で解説しています。
フィジカルAIの基本構造
構造を要素に分けると、次の5つです。
- カメラやセンサーで環境を捉える認識
- 何をすべきか考える推論
- 目標を行動の列へ分解する計画
- モーターや関節へ指令を出す制御
- 結果を確かめて行動を直すフィードバック
人間が無意識に行う「見て、考えて、動いて、確かめる」のシステム化と捉えると分かりやすくなります。このループが回り続けることが、変化する環境で働ける条件です。
VLAとは
フィジカルAIを理解する鍵がVLA(Vision-Language-Action)モデルです。視覚と言語の入力を、ロボットの運動制御へ直接変換します。「赤いコップをシンクへ」と言われたら、見て、意味を理解し、腕と手の動きに変える。LLMが言語から文章を出すのに対し、VLAは視覚と言語から行動を出します。
Google DeepMindが2026年7月に発表したGemini Robotics 2は、このVLAでヒューマノイドの足から指先までを一つのモデルで制御し、複数ロボットの協働や数分の作業に対応するとしています。計画を担う推論モデルとの2段構えで、考える脳と動かす脳を分担させる構成です。
世界モデルとシミュレーション
もう1つの鍵が世界モデルです。「この行動で世界がどう変わるか」をAI内部で予測する仕組みで、押せば倒れる、強く握れば割れる、といった物理の見通しを持たせます。
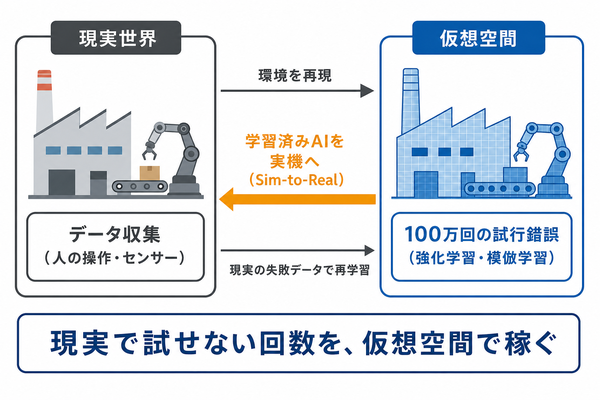
学習の中心はシミュレーションです。生成AIはWeb上の大量データで学べますが、ロボットは現実で100万回失敗できません。転倒すれば壊れ、工場は止まり、人がけがをします。そこで取られるのが、現実環境をデジタルツインとして仮想空間へ再現し、大量に試行してから実機へ移す方法です。これがSim-to-Realで、NVIDIAも物理シミュレーションと世界モデルで合成データを作り現実へ展開する手法を中核に据えています。
ロボットはどう学習するのか
学習は主に2つを組み合わせます。強化学習は、仮想空間で膨大な試行錯誤を行い、成功に報酬を与えて上達させる方法。模倣学習は、人の作業の観察や、人がロボットを遠隔操作したデータから動作を学ぶ方法です。
開発の流れは、タスク定義、データ収集、デジタルツイン作成、シミュレーション学習、実機展開、現実の失敗データでの再学習という循環です。現実と仮想を往復しながら賢くなります。
主要プレイヤーの動向
主な動きを以下の表にまとめます。
NVIDIAはロボットメーカーではなく開発・学習基盤の提供者で、多くのロボット企業が同社技術を採用しているとされます。Figureは2026年発表のHelix新版で、視覚や触覚を統合し歩行・バランス・物体操作を一つのニューラルシステムで扱う方向を示し、2台のロボットが片付けを協働するデモも公開しているとされます。国内では2026年7月、安川電機が、ソフトバンクのGPUクラウドを開発基盤に、AIロボットMOTOMAN NEXTで形の変わる柔軟物のハンドリングを実証したと発表しました。
製造・物流での活用
最も現実的なのは製造業です。従来のロボットが苦手だった少量多品種、変化の多い工程、人が判断していた作業が対象で、柔軟物の扱いはその典型です。物流では、荷下ろし、仕分け、ピッキング、搬送と、物を認識して持つ工程が広がります。人手不足が深刻な領域ほど導入の動機は明確です。
家庭・医療・建設での活用
建設・インフラでは、高所、災害現場、高温など人が入りにくい危険作業からの置き換えが進みやすく、医療・介護では完全自律より人の判断を補助する形が先行するとみられます。最後の大市場とされる家庭は、物の種類が無限で配置が毎日変わり、人もペットも動く最難関の環境です。ヒューマノイドが注目されるのは、階段もドアノブも工具も人間向けに作られた世界へ、環境を変えずに入れる可能性があるためです。
フィジカルAIの課題
課題もはっきりしています。現実では間違った行動が事故になること。長い工程の途中で1回失敗すると全体が止まること。紐や布のような柔らかい物は難しいこと。未知環境への汎用性、本体と計算資源のコスト、人と同じ空間で動く安全性、事故時の責任の所在です。
99%成功でも足りない理由
とくに見落とされがちなのが成功率の掛け算です。1工程99%の成功率でも、1,000工程を通すと全体の成功率は大きく下がります。デジタルのAIなら100回に1回のミスも許容できる場合がありますが、100回に1回皿を落とすロボットは現場に置けません。デモの1タスク成功と、毎日安全に働き続けることの間には距離があります。競争軸は「何ができるか」から「どれだけ長く、安全に、安価に、再現性高く働けるか」へ移りつつあります。
【プロの視点】教えるコストが下がる
フィジカルAIのニュースで多いのは「ロボットがこんなに賢くなった」という文脈です。ただ、産業へのインパクトを考えるなら、見るべき点は少し違います。
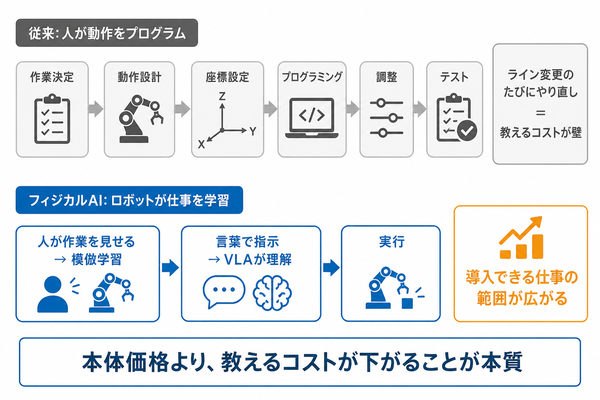
これまでロボット導入の最大の壁は、本体価格ではありませんでした。作業を決め、動作を設計し、座標を設定し、プログラムを書き、設備を調整し、テストする。ラインが変わるたびに、これをやり直す。つまりロボットに仕事を教えるコストが壁でした。教える費用が高いから、大量生産の固定工程にしか採算が合わなかったのです。
フィジカルAIが変えようとしているのはここです。人が作業を見せれば模倣学習で覚え、「この箱を棚へ運んで」と言えばVLAが理解して実行する。人が動作をプログラムする世界から、ロボットが仕事を学習する世界への転換です。
この見方をすると評価も変わります。デモの派手さではなく、新しい仕事を覚えさせるのに何日かかるか、データは何件必要か、ラインが変わったとき再学習で済むか。実際、最新モデルは少ないデータと短時間で異なる形のロボットに適応できるとされ、各社が競っているのはこの「教える速さ」です。
ロボットが普及する条件は、本体価格の低下だけではありません。教えるコストが下がることで、これまで採算が合わなかった変化の多い仕事、つまりロボットを導入できる仕事の範囲そのものが広がる。ここがフィジカルAIの本当のインパクトです。
【waltsu視点】現実に改善サイクルが入る
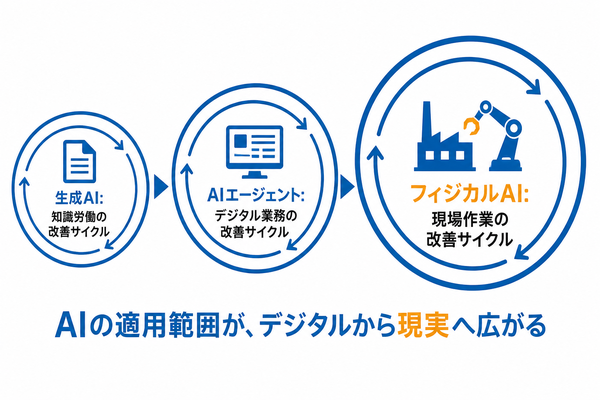
フィジカルAIは「AIが身体を持つ」と説明されますが、事業の視点では別の捉え方をおすすめします。現実世界の仕事にも、改善サイクルが入るという変化です。
生成AIは、文章を作って人が直すという知識労働の改善サイクルを高速化しました。AIエージェントは、実行して結果を見て再計画するまでをデジタル業務で回し始めました。フィジカルAIはこの循環を、工場、倉庫、店舗、建設現場という物理の現場へ持ち込みます。従来は問題のたびに人が原因を調べてプログラムを直していた場所に、自動の改善ループが生まれます。
この変化を支えるのがシミュレーションです。現実世界の最大の制約は、試行回数に物理的な上限があることでした。デジタルツインでの学習はこの制約を外し、現実の仕事の試行回数を仮想空間で稼ぐことを可能にしました。マーケティングでA/Bテストの回数が成果を分けるのと同じ構造が、現場作業にも持ち込まれたわけです。
中小企業がいま慌てる必要はありません。ただ押さえておくべきことが2つあります。1つは、人手不足で諦めていた業務の自動化範囲が数年単位で広がること。もう1つは、導入の考え方がデジタルAIと同じことです。ロボットから選ばず、業務を見て、ボトルネックを特定し、環境の変化度合いと失敗時のリスクを評価し、自動化レベルを決めてから手段を選ぶ。この順番はAI導入の原則と同じです。
デジタルで起きた変化は、少し遅れて現実世界にも来る。フィジカルAIは、その最初の大きな動きだと考えています。
よくある質問
フィジカルAIとは簡単にいうと?
AIがカメラやセンサーで現実世界を認識・理解し、ロボットなどの身体を動かして行動する技術です。見る、考える、動く、確かめるという循環で、変化する環境に対応します。
従来のロボットと何が違いますか?
従来のロボットは、事前にプログラムされた動作を正確に繰り返す機械です。フィジカルAIロボットは、その場で対象を認識し、判断して行動を変えられます。自動化から自律化への進化です。
生成AIとの関係は?
生成AIが担ってきた理解・推論の能力を、現実世界の行動へつなげたものがフィジカルAIです。視覚と言語を運動制御へ変換するVLAモデルが橋渡しをしています。
ヒューマノイドロボットのことですか?
違います。ヒューマノイドは代表例の1つで、産業用アーム、搬送ロボット、自動運転車、自律建機なども対象です。人型が注目されるのは、人間向けに作られた既存環境へそのまま入れる可能性があるためです。
いつ頃実用化されますか?
領域によります。製造や物流の特定工程では実証・導入が始まる一方、家庭のような変化の激しい環境はまだ研究段階です。単発のデモから、長時間・安全・低コストで働ける段階への移行が焦点です。
この記事のポイント
・フィジカルAI=現実を認識し、推論し、身体で行動するAI。ヒューマノイドに限らない
・鍵はVLA(視覚・言語→行動)と世界モデル、そしてシミュレーションでの学習
・本質はロボットの高性能化より「仕事を教えるコスト」が下がること
・デモの成功と社会実装の間には、長時間・安全・成功率の壁がある
フィジカルAIとは、現実世界を認識・推論し、ロボットなどの身体で行動するAIです。VLAが知識を行動へ変換し、世界モデルが物理を予測し、シミュレーションが安全な試行回数を供給する。この組み合わせによって、ロボットは「プログラムされた通りに動く機械」から「仕事を学習する存在」へ変わり始めています。
生成AI、AIエージェント、フィジカルAIは、答える、デジタルで行動する、現実で行動する、という連続した進化です。デジタルの仕事で起きた変化は、これから現場の仕事にも広がっていきます。
まずは、人手不足や危険を理由に自動化を諦めていた作業を書き出し、「環境がどれだけ変化するか」で並べてみてください。そのうえで、AI活用をデジタル業務のどこから進めるべきか、業務整理や導入の順番に迷う場面が出てきたら、waltsuがAI活用の設計から導入・検証までご支援します。