 マワルくん
・顧客名をAIに入力してよいか迷う
・入力情報が学習されるのか不安
・社内のAI利用ルールを作りたい
ChatGPTなどの生成AIを業務で使うとき、「顧客名を入力しても大丈夫?」「入力した情報は学習される?」という不安は、ほぼすべての企業で聞かれます。不安なまま個人の判断で使われるか、「全部禁止」でAI活用ごと止まるか、に振れている企業が少なくありません。
生成AIへ個人情報を入力すること=直ちに違法、という単純な話ではありません。重要なのは、何の情報を、何の目的で、どのAIサービスへ渡し、そのデータがAI事業者側でどう扱われるかを確認すること。個人情報保護委員会も2023年6月の注意喚起で、本人の同意なく個人データを入力する場合、AI事業者がそのデータを回答生成以外の目的(モデル学習など)に利用しないことを十分確認するよう求めています。本記事では、用語の区別、主なリスク、「全部学習される」という誤解、RAG・AIエージェント時代の新しい論点、企業が作るべきルールまで解説します。なお本記事は一般的な情報提供が目的です。個別の法的判断は契約・データフローで異なるため、必要に応じて法務・専門家へ確認してください。
この記事のゴール(読了目安 約10分)
「個人情報だから禁止」ではなく、情報の分類・利用目的・AIサービスの条件・権限の組み合わせで、安全に使える境界線を自社で設計できるようになる。
生成AIと個人情報の問題とは
4つの場面に分けて考える
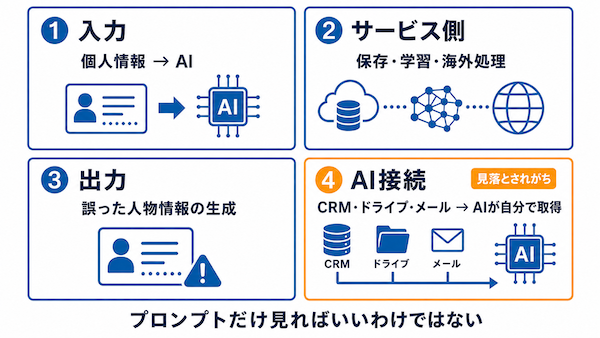
生成AIと個人情報の問題は1つではありません。①AIへ入力する情報(氏名・顧客情報など)、②AIサービス側での取り扱い(保存・学習・海外処理)、③AIから出力される情報(実在人物についての誤った生成)、④AIが接続先から取得する情報(CRM・ドライブ・メールなど)。この4つの場面で別のリスクが発生します。
入力だけの問題ではない
見落とされがちなのが④です。RAGやAIエージェントでは、人が書かなくても、AIが社内システムから個人情報を取得できます。つまり「プロンプトへ何を書いたか」だけの管理では不十分で、「AIが何を見られるか」まで設計する必要があります。この視点は記事後半で扱います。
個人情報・個人データ・要配慮個人情報
まず言葉を3つ区別します。以下の表にまとめます。
ポイントは3つあります。名前がなくても、他の情報と容易に照合して個人を識別できれば個人情報になりえること。名刺1枚とCRMの名簿10万件では第三者提供や安全管理など関係する規律が変わるため、生成AIでは「個人データに該当するか」が重要な確認点になること。そして要配慮個人情報は取得に原則本人同意が必要とされるなど特に慎重な扱いが求められるため、「原則AI入力禁止」など通常より強い社内ルールを設定する方法が考えられることです。
入力=違法ではない
「契約済みの法人向けAIで顧客問い合わせを要約する」という利用が、それだけで直ちに違法になるわけではありません。
確認すべきなのは、利用目的(取得時の目的とAI利用が整合するか)、AIサービス側の利用(回答生成以外に使われるか)、契約(委託として整理・管理できるか)、データフロー(第三者提供の構造か、海外で処理されるか)、安全管理(アクセス権・ログ)です。個人情報保護委員会の注意喚起でも、核心は「AI事業者が、入力された個人データを回答生成以外の目的で取り扱うかどうか」に置かれています。「個人情報だからNG」でなく「その情報がどう扱われるか」を見る。これが出発点です。
主なリスクは7つ
リスクは学習だけではありません。モデル学習への利用、サービス側での保存、第三者提供・委託の整理、海外移転、アカウント侵害による履歴閲覧、社員の誤入力、実在人物に関する不正確な出力の7つです。
とくに6つ目の誤入力は運用の問題で、発生頻度が最も高いリスクです。7つ目の出力リスクは入力管理では防げません。AIが生成した人物情報には古い情報・混同・推測が含まれうるため、採用・審査など個人に重大な影響を与える判断へそのまま使わないのが原則です。元データの確認と人の判断を挟んでください。
「全部学習される」は誤解
「入力した情報はすべて学習される」という理解は、現在では正確ではありません。データの扱いは製品・プラン・設定・契約の組み合わせで決まります。
OpenAIの場合、ChatGPT Business・Enterprise・Edu・APIといった法人向けサービスでは、入力・出力をデフォルトでモデル学習に利用しないとの説明です。一方、個人向けのFree・Plus・Proではモデル改善へのデータ共有がデフォルトで有効で、設定でオフにでき、オフ以降の新しい会話は学習に使用されないとされています。「ChatGPTは安全か」という抽象的な問いに答えはなく、どの製品を、どの設定・契約で使っているかが正しい問いです。仕様は変わりうるため、定期的な規約確認を前提にしてください。
個人アカウント利用が問題な理由
社員が個人の無料アカウントへ顧客データを貼り付ける——企業として最も避けたい状態です。問題は学習の有無だけではありません。
契約を管理できない、設定を把握できない、ログを監査できない、退職後もデータが個人アカウントに残りうる。つまり「企業が管理できないこと」自体が問題です。業務利用では、法人向け環境+SSO+管理者設定という管理可能な形が対策の前提です。管理外のAI利用が広がる構図は、シャドーAIの記事で解説しています。
法人向けなら何でも入力してよい?
これも誤りです。学習利用がないのはAI事業者側の安全性の話で、自社側の適法性・必要性は別問題として残ります。
第1に利用目的。目的をできる限り特定し、原則その範囲を超えて取り扱わないことが求められるため、発送のために取得した顧客情報をAIで別目的の分析に使ってよいかは、当初の目的との関係で確認が必要です。第2に第三者提供・委託の整理。外部AIサービスへ個人データを渡すことを委託として整理できるか、契約とデータフローの確認が要ります。第3に海外移転。外国にある第三者への提供には本人同意等が必要になる規律がありますが、海外サービス=一律に同意が必要とも決まらず、提供関係・契約・処理構造で判断が変わります。いずれも個別性が高いため、迷う場合は専門家へ確認してください。
マスキングと必要最小限
実務で最も効果が大きい対策が、渡す情報を減らすことです。「山田太郎さん(35歳・ABC社勤務)」を「顧客A(30代・製造業勤務)」とするマスキングは有効な方法の1つです。
ただし、名前を消せば安全とは限りません。従業員5人の会社の「代表取締役」のように、他の情報の組み合わせで個人を特定できる場合があるためです。もう1つの原則がデータ最小化です。顧客メールを書き直すタスクに必要なのは本文だけで、氏名・住所・購入履歴は不要かもしれません。「何を渡せるか」ではなく「このタスクに何が本当に必要か」から考えてください。
情報を4レベルに分類する
社内ルールは、禁止リストの羅列より、情報のレベル分けが実用的です。以下の表にまとめます。
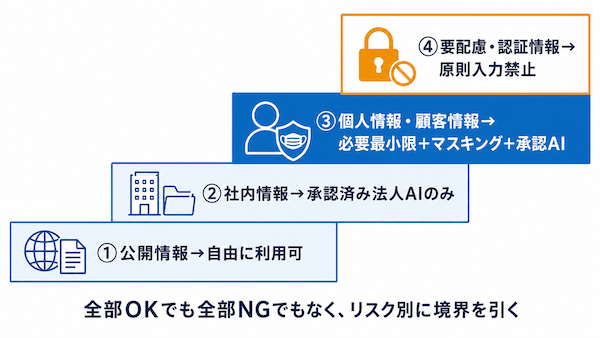
「全部OK」でも「全部NG」でもなくリスク別に境界を引く。さらに、文章校正のような低リスク用途と採用評価のような高リスク用途で人の確認レベルを変えると、ルールを現場で運用しやすくなります。
RAG・AIエージェントの新しい論点
「RAGなら学習させないから安全」と思われがちですが、別のリスクがあります。検索権限の問題です。本来は人事部しか見られない情報を、AI経由なら全社員が閲覧できてしまう——という権限設定の穴が典型です。RAGでは「誰が、どのデータへ、AIを通じてアクセスできるか」の設計が、学習リスクより重要になります。
AIエージェントでは、さらに広がります。社員が何も入力しなくても、AIがCRM・メール・ドライブから個人情報を自分で取得し、メール送信やCRM更新まで実行できる場合があるためです。外部アプリ連携(コネクタ)でも、接続先の情報へAIがアクセスします。プロンプトのルールだけでは足りず、AIのID・データアクセス範囲・ツール権限・人の承認・監査ログの管理が必要です。この設計はAIエージェントセキュリティの記事で解説しています。
企業が行うべき対策
対策は8つです。
- 承認AIを決める: 会社として利用可能なAIの一覧を定める
- データを分類する: 前述の4レベルなど、情報の区分を先に作る
- 入力ルールを作る: レベルごとに利用可否・条件(マスキング等)を決める
- 法人向け環境を使う: 学習利用・管理機能・ログの観点から標準の利用環境にする
- 利用目的を確認する: 取得時の目的とAI利用の整合を、導入前にチェックする
- 権限とログを管理する: 誰が・何を使ったかを確認できる状態にする
- 教育する: 最大のリスクは「知らずに貼り付ける」こと。ルールの背景まで伝える
- 誤入力時の手順を決める: 報告先、履歴削除、漏えい等報告の要否確認まで事前に定める
あわせて、経済産業省・総務省の「AI事業者ガイドライン」(2026年3月に第1.2版を公表)も参考になります。チェックリスト等の実務資料も提供されており、個人情報保護法+公的ガイドラインを土台に自社ルールを組むのが近道です。社内ルール全体の作り方は、生成AIガイドラインの記事で解説しています。
【プロの視点】提供者側の利用目的を見る
「個人情報をAIに入れていいですか?」には「ダメです」と答えるのが一番簡単です。しかしそれでは、顧客問い合わせ100件を分類したいという現実の業務が進みません。
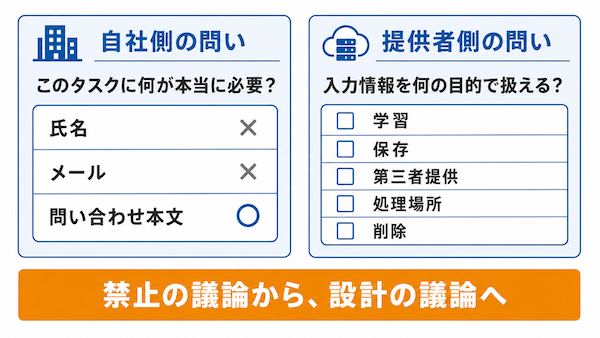
実務で機能する問いは2つです。1つ目は自社側の問い——「このタスクに、どの情報が本当に必要か」。氏名は不要、問い合わせ本文だけ必要、と分解すれば、識別情報を削除して承認済みの法人AIへ渡す設計が成立します。2つ目は提供者側の問い——「AI事業者は、入力された情報を何の目的で扱えるか」。個人情報保護委員会の注意喚起の核心もここにあります。学習の有無だけでなく、保存、利用目的、第三者への提供、処理される場所、削除の可否まで、契約と規約で確認する。
「使う/使わない」の二択ではなく、データをどこまで減らし、どの条件の環境へ渡すか。この問いに置き換えると、議論は「禁止」から「設計」に変わります。
【waltsu視点】入力管理からアクセス管理へ
これまでの個人情報対策は、「顧客名を入力しない」という入力管理で成立していました。人が書く情報だけを見張ればよかったからです。
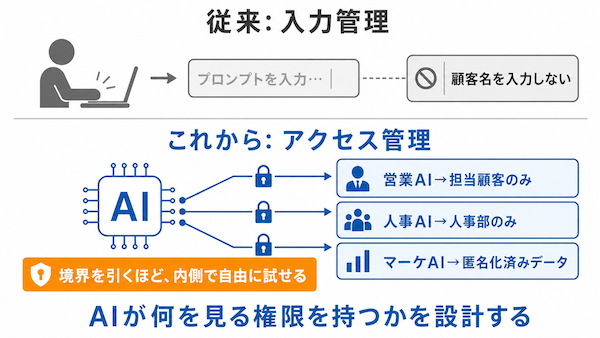
しかしAIはいま、ドライブ・メール・CRMへ接続され、エージェントとして自分でデータを取りに行きます。人が何も入力しなくても、AIは顧客情報へ到達可能です。対策の中心は「何を入力してよいか」から「このAIは何を見る権限を持つか」へ移ります。営業AIには担当顧客の範囲だけ、人事AIは人事部のみ、マーケティングAIには匿名化済みデータ——というAIごとのアクセス範囲の設計です。
この設計を勧める理由は、守りのためだけではありません。見てよい範囲が明確なAIは、その範囲内で安心して使い倒せます。境界が曖昧なままでは1件ずつ可否を判断することになり、活用は進みません。境界を引くほど、内側で自由に試せる。個人情報の管理とは、AIを止めることではなく、安全に試行を増やすための線引きです。
よくある質問
生成AIに個人情報を入力しても大丈夫?
入力しただけで直ちに違法になるわけではありません。ただし、利用目的の整合、AI事業者側での利用(学習・保存)、契約、第三者提供・海外移転、安全管理措置の確認が必要です。
ChatGPTに入力すると学習されますか?
製品と設定によります。Business・Enterprise・Edu・APIなど法人向けは、デフォルトで入出力をモデル学習に利用しないとされています。個人向けは共有設定がデフォルト有効で、オフにすることも可能です。
法人向けプランなら何を入力してもよい?
いいえ。学習に利用されないことは重要な保護策ですが、利用目的の整合、必要性、アクセス権、個人情報保護法上の整理は自社側の確認事項です。事業者の安全性と自社の適法性は別問題です。
氏名を消せば入力できますか?
有効ですが、それだけでは足りない場合があります。会社名・役職・地域の組み合わせで個人を特定できることがあるためです。不要な識別情報をできる限り削除し、特定可能性を確認してください。
RAGやAIエージェントでは何に注意すべき?
RAGは検索権限(本来見られない情報がAI経由で見える穴)、エージェントはアクセス範囲と実行権限が論点です。プロンプト管理だけでなく、AIが見られるデータと実行できる操作の設計が必要です。
まとめ
この記事の要点
・生成AIへの個人情報入力=直ちに違法ではない。「その情報がどう扱われるか」を確認する
・確認の核心は、AI事業者が回答生成以外の目的(学習など)で扱うかどうか。製品・設定・契約で決まる
・情報を4レベルに分類し、マスキングと必要最小限を組み合わせて境界を作る
・RAG・エージェント時代は「何を入力したか」より「AIが何を見られるか」の設計へ
生成AIと個人情報の問題は、「全部禁止」でも「全部OK」でもなく、境界の設計です。用語を区別し、利用目的とAIサービス側の扱いを確認し、情報を分類して、必要最小限を承認された環境へ渡す。そしてRAG・AIエージェントの時代には、入力の管理からアクセス範囲の管理へと対策の中心が移ります。
まずは承認AIの決定とデータ分類から始めてください。「入力ルールをどう作ればよいか」「RAGやエージェントの権限をどう設計すべきか」という段階から整理したい場合は、waltsuが生成AIガイドラインの策定・データ分類・AI業務導入の設計までご支援します。